Robots.txt Generator
Kostenloser Robots.txt Generator
Erstellen Sie eine ordnungsgemäße robots.txt-Datei für Ihre Website, ohne Code von Grund auf neu schreiben zu müssen.
Dieses kostenlose Tool hilft Ihnen dabei, die Regeln zu erstellen, die Suchmaschinen-Bots mitteilen, welche Teile Ihrer Website sie durchsuchen dürfen und welche Bereiche sie überspringen sollen. Füllen Sie die Optionen aus, generieren Sie die Datei und laden Sie sie in das Stammverzeichnis Ihrer Website hoch.
Was ist eine robots.txt-Datei?
Robots.txt ist eine einfache Textdatei, die sich im Stammordner Ihrer Website befindet (Beispiel: https://yoursite.com/robots.txt).
Wenn Suchmaschinen wie Google Ihre Website besuchen, suchen sie nach dieser Datei, um die Crawling-Anweisungen zu verstehen, die für verschiedene Bots bereitgestellt werden.
Sie können sie verwenden, um:
- Das Crawlen wichtiger Seiten zu erlauben
- Private, Admin- oder doppelte Abschnitte zu blockieren
- Bots auf Ihre XML-Sitemap hinzuweisen
- Unnötiges Crawlen auf großen Websites zu reduzieren
Sie versteckt keine Seiten vor Benutzern und ist kein Sicherheitstool. Sie stellt lediglich Crawling-Anweisungen bereit, denen konforme Suchmaschinen-Bots folgen können.
Warum Sie möglicherweise eine robots.txt-Datei benötigen
Nicht jede kleine Website benötigt eine komplexe robots.txt, aber sie wird nützlich, wenn:
- Sie Admin- oder Login-Seiten haben, die nicht gecrawlt werden sollen
- Ihre Website viele doppelte oder gefilterte URLs generiert
- Sie das Crawlen von Test- oder Staging-Bereichen verwalten möchten
- Sie eine große Website betreiben und die Crawl-Aktivität verwalten möchten
- Sie WordPress verwenden und den Zugriff auf bestimmte Systemordner verwalten möchten
Eine gut geschriebene robots.txt-Datei kann Suchmaschinen dabei helfen, ihr Crawling auf die Bereiche Ihrer Website zu konzentrieren, auf die sie zugreifen sollen.
Wie man diesen Generator verwendet
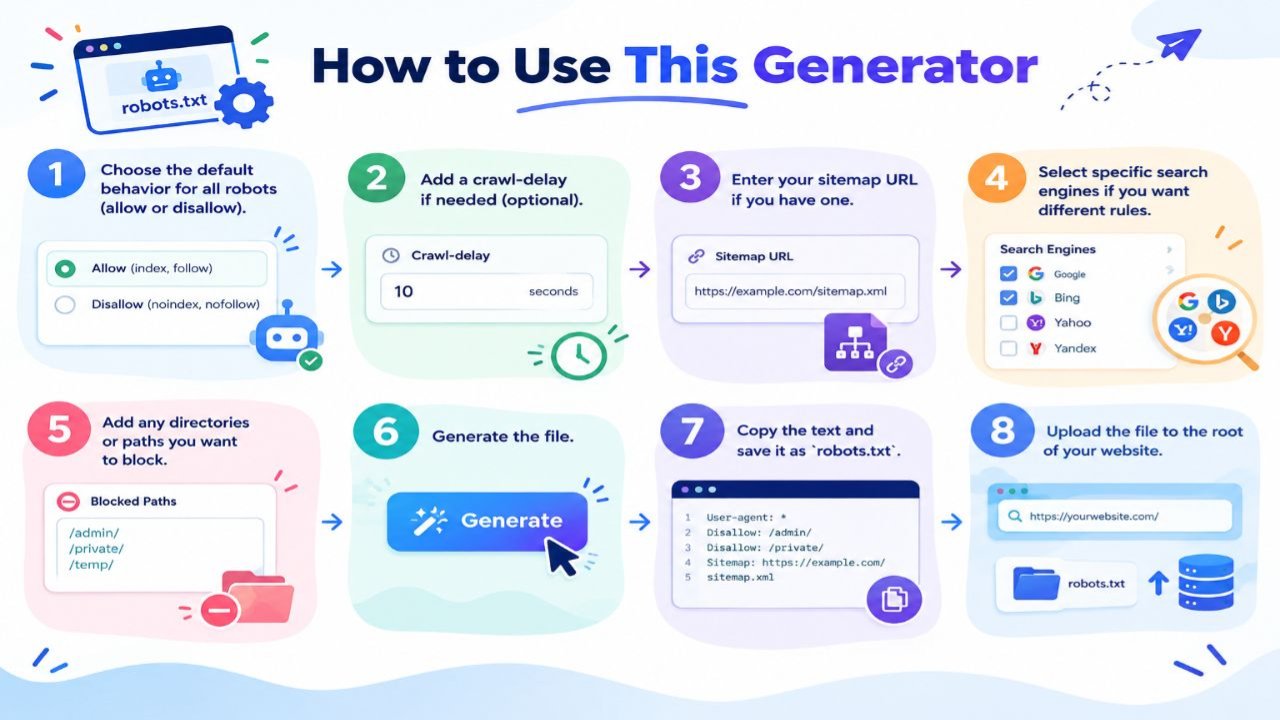
- Wählen Sie das Standardverhalten für alle Robots (erlauben oder verbieten).
- Fügen Sie bei Bedarf eine Crawl-Verzögerung hinzu (optional).
- Geben Sie Ihre Sitemap-URL ein, falls Sie eine haben.
- Wählen Sie spezifische Suchmaschinen aus, wenn Sie andere Regeln wünschen.
- Fügen Sie Verzeichnisse oder Pfade hinzu, die Sie blockieren möchten.
- Generieren Sie die Datei.
- Kopieren Sie den Text und speichern Sie ihn als
robots.txt. - Laden Sie die Datei in das Stammverzeichnis Ihrer Website hoch.
Öffnen Sie nach dem Hochladen https://yourdomain.com/robots.txt in Ihrem Browser und überprüfen Sie, ob die Datei korrekt geladen wird. Sie können auch das Tool URL-Prüfung der Google Search Console verwenden, um zu überprüfen, ob auf bestimmte URLs von Google zugegriffen werden kann. Denken Sie daran, dass robots.txt das Crawling steuert und eine Seite nicht direkt aus den Suchergebnissen von Google entfernt.
Wichtige Dinge, an die Sie sich erinnern sollten
- Ein kleiner Fehler kann das Crawlen wichtiger Seiten verhindern.
- Überprüfen Sie die generierten Regeln vor dem Hochladen immer doppelt.
- Verwenden Sie robots.txt niemals, um sensible Inhalte zu verbergen. Verwenden Sie stattdessen einen ordnungsgemäßen Passwortschutz oder geeignete Noindex-Steuerungen.
- Robots.txt und XML-Sitemaps arbeiten zusammen, dienen aber unterschiedlichen Zwecken.
- Geben Sie Suchmaschinen nach dem Hochladen einer neuen robots.txt etwas Zeit, um die Änderungen zu bemerken.
Gängige Direktiven einfach erklärt
| Direktive | Was sie tut |
|---|---|
| User-agent | Gibt an, für welchen Bot die Regel gilt. |
| Disallow | Blockiert eine Seite oder einen Ordner vom Crawling. |
| Allow | Erlaubt den Zugriff auf eine Seite oder einen Pfad, was für Ausnahmen nützlich sein kann. |
| Sitemap | Teilt Suchmaschinen-Bots mit, wo sich Ihre XML-Sitemap befindet. |
| Crawl-delay | Schlägt eine Pause zwischen Crawler-Anfragen vor. Die Unterstützung kann je nach Suchmaschine variieren. |
Verwandte kostenlose Tools
- Meta-Tags-Analysator
- Meta-Tag-Generator
- Domain Authority Checker
- Backlink Checker
- Keyword-Position-Checker
Hinweis
Dieser Generator erstellt eine Standard-robots.txt-Datei basierend auf den von Ihnen ausgewählten Optionen. Überprüfen Sie den finalen Code vor der Veröffentlichung immer sorgfältig. Falsche Regeln können Suchmaschinen daran hindern, auf wichtige Inhalte auf Ihrer Website zuzugreifen.