Robots.txt Generator
फ्री रोबोट्स डॉट टीएक्सटी जेनरेटर
स्क्रैच से कोड लिखे बिना अपनी वेबसाइट के लिए एक उचित robots.txt फ़ाइल बनाएँ।
यह मुफ़्त टूल आपको वे नियम बनाने में मदद करता है जो सर्च इंजन बॉट्स को बताते हैं कि आपकी साइट के किन हिस्सों को वे क्रॉल कर सकते हैं और किन क्षेत्रों को उन्हें छोड़ना चाहिए। विकल्पों को भरें, फ़ाइल जनरेट करें, और इसे अपनी वेबसाइट के रूट डायरेक्टरी में अपलोड करें।
Robots.txt फ़ाइल क्या है?
Robots.txt एक साधारण टेक्स्ट फ़ाइल है जो आपकी वेबसाइट के रूट फ़ोल्डर में होती है (उदाहरण: https://yoursite.com/robots.txt)।
जब Google जैसे सर्च इंजन आपकी साइट पर आते हैं, तो वे अलग-अलग बॉट्स के लिए प्रदान किए गए क्रॉलिंग निर्देशों को समझने के लिए इस फ़ाइल को देखते हैं।
आप इसका उपयोग इनके लिए कर सकते हैं:
- महत्वपूर्ण पृष्ठों को क्रॉल करने की अनुमति देना
- निजी, एडमिन, या डुप्लीकेट अनुभागों को ब्लॉक करना
- बॉट्स को आपके XML साइटमैप की ओर इंगित करना
- बड़ी वेबसाइटों पर अनावश्यक क्रॉलिंग को कम करना
यह उपयोगकर्ताओं से पृष्ठों को छुपाता नहीं है और यह कोई सुरक्षा टूल नहीं है। यह केवल क्रॉलिंग निर्देश प्रदान करता है जिनका अनुपालन करने वाले सर्च इंजन बॉट्स पालन कर सकते हैं।
आपको Robots.txt फ़ाइल की आवश्यकता क्यों हो सकती है
हर छोटी वेबसाइट को एक जटिल robots.txt की आवश्यकता नहीं होती है, लेकिन यह तब उपयोगी हो जाता है जब:
- आपके पास एडमिन या लॉगिन पेज हैं जिन्हें आप क्रॉल नहीं करवाना चाहते हैं
- आपकी साइट कई डुप्लीकेट या फ़िल्टर किए गए यूआरएल जनरेट करती है
- आप परीक्षण या स्टेजिंग क्षेत्रों के क्रॉलिंग को प्रबंधित करना चाहते हैं
- आप एक बड़ी साइट चलाते हैं और क्रॉल गतिविधि को प्रबंधित करना चाहते हैं
- आप WordPress का उपयोग करते हैं और कुछ सिस्टम फ़ोल्डर्स तक पहुंच को प्रबंधित करना चाहते हैं
एक अच्छी तरह से लिखी गई robots.txt फ़ाइल सर्च इंजन को आपकी वेबसाइट के उन क्षेत्रों पर अपनी क्रॉलिंग केंद्रित करने में मदद कर सकती है जिन तक आप उन्हें पहुंचाना चाहते हैं।
इस जेनरेटर का उपयोग कैसे करें
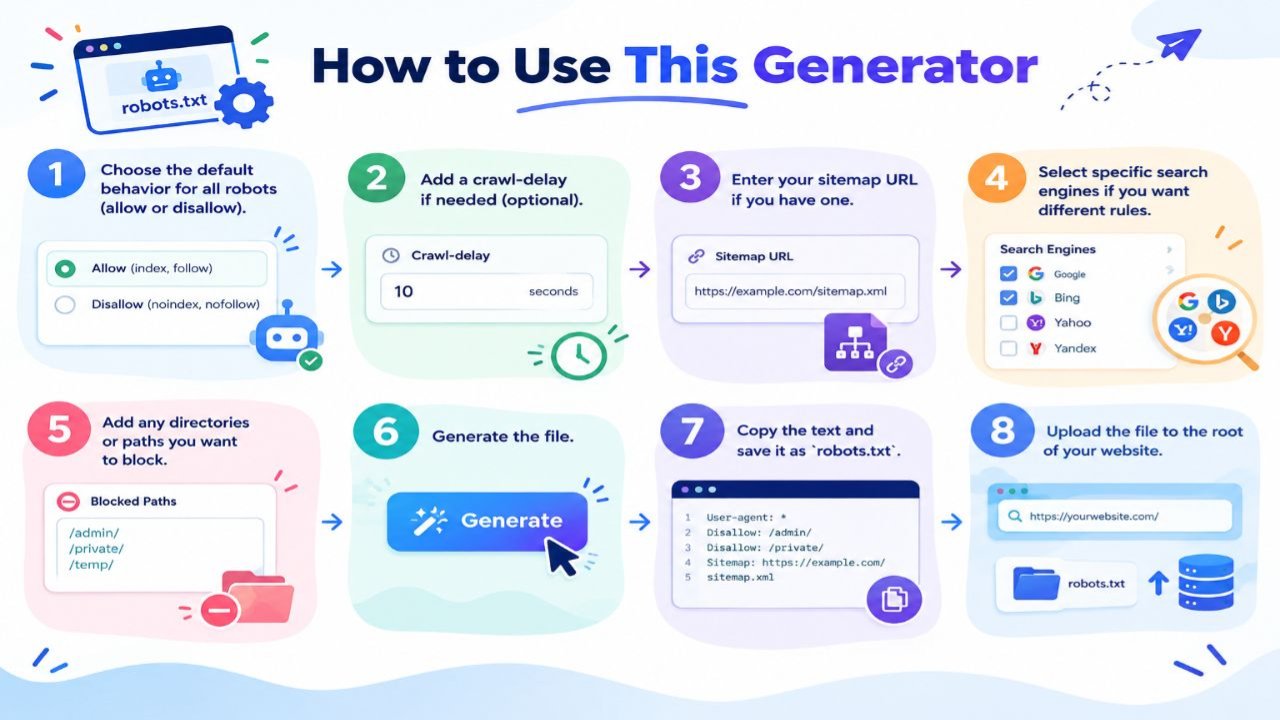
- सभी रोबोटों के लिए डिफ़ॉल्ट व्यवहार चुनें (अनुमति दें या अस्वीकार करें)।
- यदि आवश्यक हो तो क्रॉल-डिले (crawl-delay) जोड़ें (वैकल्पिक)।
- यदि आपके पास कोई साइटमैप यूआरएल है तो उसे दर्ज करें।
- यदि आप अलग-अलग नियम चाहते हैं तो विशिष्ट सर्च इंजन चुनें।
- कोई भी निर्देशिका या पथ जोड़ें जिसे आप ब्लॉक करना चाहते हैं।
- फ़ाइल जनरेट करें।
- टेक्स्ट को कॉपी करें और इसे
robots.txtके रूप में सहेजें। - फ़ाइल को अपनी वेबसाइट के रूट में अपलोड करें।
अपलोड करने के बाद, अपने ब्राउज़र में https://yourdomain.com/robots.txt खोलें और जांचें कि फ़ाइल सही ढंग से लोड हो रही है या नहीं। आप यह जांचने के लिए Google Search Console के URL Inspection टूल का भी उपयोग कर सकते हैं कि विशिष्ट यूआरएल को Google द्वारा एक्सेस किया जा सकता है या नहीं। याद रखें कि robots.txt क्रॉलिंग को नियंत्रित करता है और सीधे Google के खोज परिणामों से किसी पृष्ठ को नहीं हटाता है।
याद रखने योग्य महत्वपूर्ण बातें
- एक छोटी सी गलती महत्वपूर्ण पृष्ठों को क्रॉल होने से रोक सकती है।
- अपलोड करने से पहले हमेशा जनरेट किए गए नियमों की दोबारा जांच करें।
- संवेदनशील सामग्री को छिपाने के लिए कभी भी robots.txt का उपयोग न करें। इसके बजाय उचित पासवर्ड सुरक्षा या उपयुक्त noindex नियंत्रणों का उपयोग करें।
- Robots.txt और XML साइटमैप एक साथ काम करते हैं लेकिन अलग-अलग उद्देश्यों को पूरा करते हैं।
- एक नया robots.txt अपलोड करने के बाद, सर्च इंजन को बदलावों पर ध्यान देने के लिए कुछ समय दें।
सामान्य निर्देशों को सरल रूप में समझाया गया
| निर्देश (Directive) | यह क्या करता है |
|---|---|
| User-agent | निर्दिष्ट करता है कि यह नियम किस बॉट पर लागू होता है। |
| Disallow | किसी पृष्ठ या फ़ोल्डर को क्रॉल करने से रोकता है। |
| Allow | किसी पृष्ठ या पथ तक पहुंच की अनुमति देता है, जो अपवादों के लिए उपयोगी हो सकता है। |
| Sitemap | सर्च इंजन बॉट्स को बताता है कि आपका XML साइटमैप कहाँ स्थित है। |
| Crawl-delay | क्रॉलर अनुरोधों के बीच रुकने का सुझाव देता है। सर्च इंजनों के बीच समर्थन भिन्न हो सकता है। |
संबंधित मुफ़्त टूल
- Meta Tags Analyzer
- Meta Tag Generator
- Domain Authority Checker
- Backlink Checker
- Keyword Position Checker
नोट
यह जेनरेटर आपके द्वारा चुने गए विकल्पों के आधार पर एक मानक robots.txt फ़ाइल बनाता है। इसे प्रकाशित करने से पहले हमेशा अंतिम कोड की सावधानीपूर्वक समीक्षा करें। गलत नियम सर्च इंजन को आपकी साइट पर महत्वपूर्ण सामग्री तक पहुँचने से रोक सकते हैं।