Robots.txt Generator
免费 Robots.txt 生成器
无需从头编写代码,即可为您的网站创建合适的 robots.txt 文件。
这个免费工具可帮助您构建规则,告诉搜索引擎蜘蛛您网站的哪些部分可以抓取,哪些区域应该跳过。填写选项、生成文件,并将其上传到您网站的根目录。
什么是 robots.txt 文件?
Robots.txt 是一个简单的文本文件,位于您网站的根文件夹中(例如:https://yoursite.com/robots.txt)。
当像 Google 这样的搜索引擎访问您的网站时,它们会查找此文件,以了解为不同蜘蛛提供的抓取指令。
您可以使用它来:
- 允许抓取重要页面
- 屏蔽私密、管理或重复的部分
- 引导蜘蛛访问您的 XML 站点地图
- 减少大型网站上不必要的抓取
它不会向用户隐藏页面,也不是安全工具。它仅提供合规的搜索引擎蜘蛛可能会遵循的抓取指令。
为什么您可能需要 Robots.txt 文件
并非每个小型网站都需要复杂的 robots.txt,但在以下情况下它会变得非常有用:
- 您有不希望被抓取的管理或登录页面
- 您的网站生成了许多重复或经过筛选的 URL
- 您想要管理测试或预发布区域的抓取
- 您运营着一个大型网站并希望管理抓取活动
- 您使用 WordPress 并希望管理对某些系统文件夹的访问权限
一份编写良好的 robots.txt 文件可以帮助搜索引擎将其抓取集中在您希望它们访问的网站区域。
如何使用此生成器
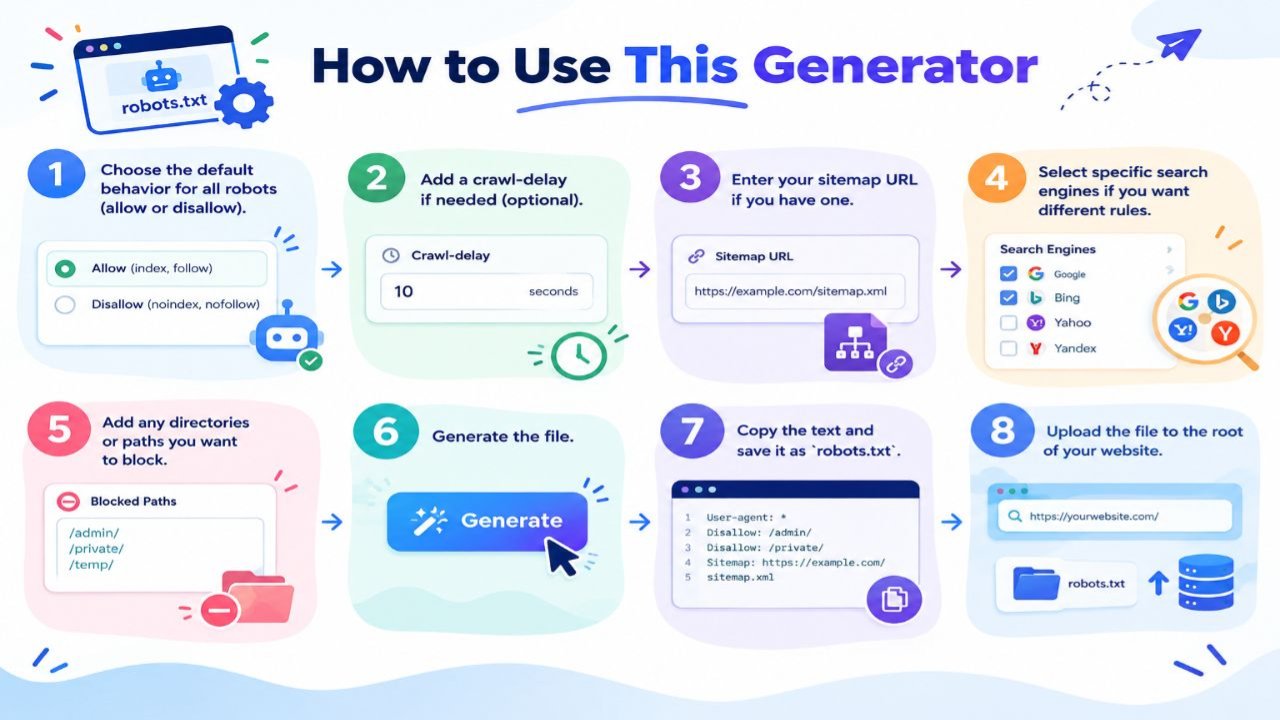
- 选择所有机器人的默认行为(允许或禁止)。
- 如果需要,添加抓取延迟(可选)。
- 如果您有站点地图,请输入其 URL。
- 如果您想要不同的规则,请选择特定的搜索引擎。
- 添加您要屏蔽的任何目录或路径。
- 生成文件。
- 复制代码并将其保存为
robots.txt。 - 将文件上传到您网站的根目录。
上传后,在浏览器中打开 https://yourdomain.com/robots.txt 并检查文件是否正确加载。您还可以使用 Google 搜索控制台的网址检查工具来检查 Google 是否可以访问特定 URL。请记住,robots.txt 控制的是抓取,并不会直接从 Google 的搜索结果中移除页面。
需要牢记的重要事项
- 一个小小的小错误可能会阻止重要页面被抓取。
- 在上传之前,请务必仔细检查生成的规则。
- 切勿使用 robots.txt 来隐藏敏感内容。请改用适当的密码保护或适当的 noindex 控制。
- Robots.txt 和 XML 站点地图协同工作,但用途不同。
- 上传新的 robots.txt 后,请给搜索引擎一些时间来注意到这些更改。
常见指令简单解释
| 指令 | 它的作用 |
|---|---|
| User-agent | 指定该规则适用于哪个蜘蛛。 |
| Disallow | 阻止抓取某个页面或文件夹。 |
| Allow | 允许访问某个页面或路径,这对于例外情况非常有用。 |
| Sitemap | 告诉搜索引擎蜘蛛您的 XML 站点地图位于何处。 |
| Crawl-delay | 建议在抓取请求之间暂停。不同搜索引擎的支持情况可能会有所不同。 |
相关免费工具
注意
本生成器根据您选择的选项创建一个标准的 robots.txt 文件。在发布最终代码之前,请务必仔细检查。不正确的规则可能会阻止搜索引擎访问您网站上的重要内容。