Robots.txt Generator
無料 Robots.txt ジェネレーター
コードを一から書くことなく、ウェブサイト用の適切な robots.txt ファイルを作成できます。
この無料ツールを使用すると、検索エンジンのボットに対してサイトのどの部分をクロールし、どの部分をスキップすべきかを指示するルールを作成できます。オプションを入力し、ファイルを生成して、ウェブサイトのルートディレクトリにアップロードしてください。
robots.txt ファイルとは何ですか?
Robots.txt は、ウェブサイトのルートフォルダーに配置されるシンプルなテキストファイルです(例:https://yoursite.com/robots.txt)。
Google などの検索エンジンがサイトを訪れる際、さまざまなボットに提供されているクロール指示を理解するためにこのファイルを確認します。
これを使用して以下のことが行えます:
- 重要なページのクロールを許可する
- プライベート、管理画面、または重複するセクションをブロックする
- XML サイトマップへのリンクをボットに伝える
- 大規模なウェブサイトでの不要なクロールを減らす
これはユーザーからページを隠すものではなく、セキュリティツールでもありません。準拠している検索エンジンのボットが従う可能性のあるクロール指示を提供するだけです。
robots.txt ファイルが必要となる理由
すべての小規模なウェブサイトに複雑な robots.txt が必要なわけではありませんが、以下のような場合に役立ちます:
- クロールさせたくない管理ページやログインページがある
- サイトで多くの重複URLやフィルター済みURLが生成される
- テスト環境やステージング環境のクロールを管理したい
- 大規模なサイトを運営しており、クロールアクティビティを管理したい
- WordPress を使用しており、特定のシステムフォルダーへのアクセスを管理したい
適切に記述された robots.txt ファイルは、検索エンジンがアクセスさせたいウェブサイトの領域にクロールを集中させるのに役立ちます。
このジェネレーターの使用方法
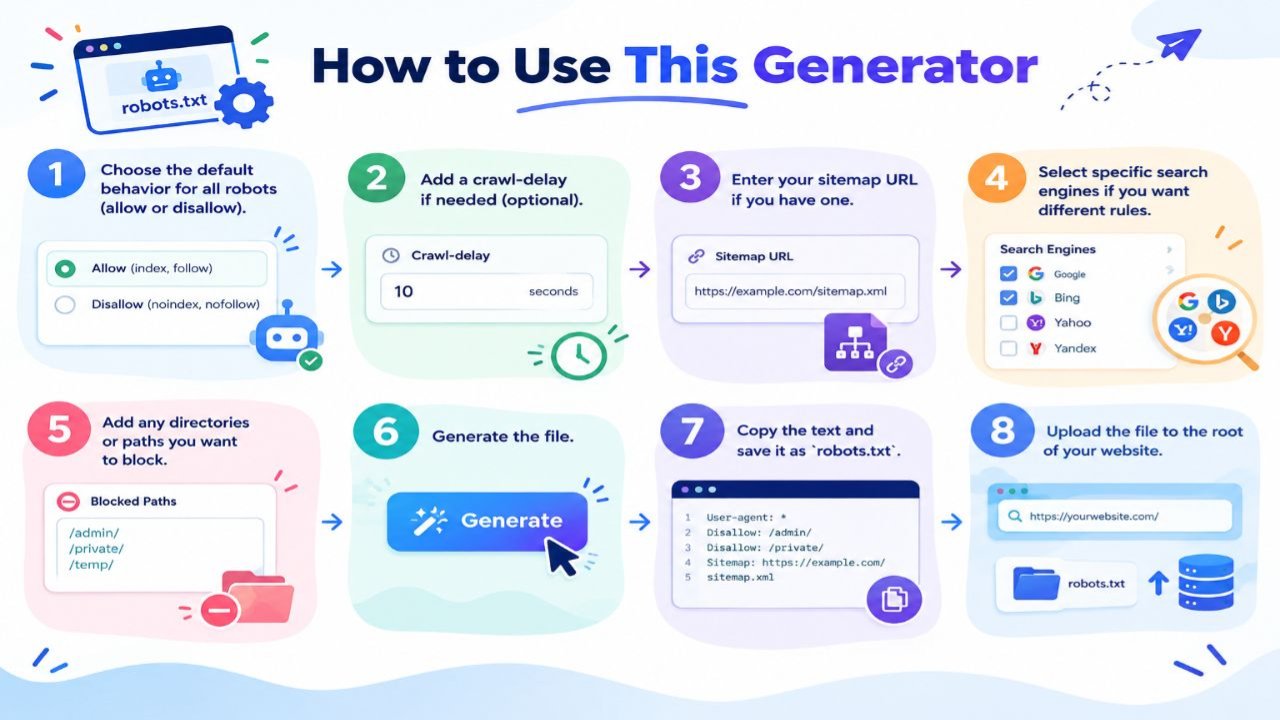
- すべてのロボットのデフォルトの動作(許可または拒否)を選択します。
- 必要に応じてクロール遅延(crawl-delay)を追加します(オプション)。
- サイトマップをお持ちの場合は、そのURLを入力します。
- 異なるルールを適用したい特定の検索エンジンを選択します。
- ブロックしたいディレクトリやパスを追加します。
- ファイルを生成します。
- テキストをコピーし、
robots.txtという名前で保存します。 - ファイルをウェブサイトのルートにアップロードします。
アップロード後、ブラウザで https://yourdomain.com/robots.txt を開き、ファイルが正しく読み込まれていることを確認してください。また、Google サーチコンソールのURL 検査ツールを使用して、特定のURLにGoogleがアクセスできるかどうかを確認することもできます。robots.txt はクロールを制御するものであり、Googleの検索結果からページを直接削除するものではないことに注意してください。
覚えておくべき重要な事項
- 小さな間違いで重要なページのクロールがブロックされる可能性があります。
- アップロードする前に、生成されたルールを必ず再確認してください。
- 機密コンテンツを隠すために robots.txt を絶対に使用しないでください。代わりに適切なパスワード保護や適切な noindex 制御を使用してください。
- Robots.txt と XML サイトマップは連携して機能しますが、目的は異なります。
- 新しい robots.txt をアップロードした後、検索エンジンに変更を認識するまで少し時間を与えてください。
一般的なディレクティブの簡単な説明
| ディレクティブ | 機能 |
|---|---|
| User-agent | ルールが適用されるボットを指定します。 |
| Disallow | ページやフォルダーのクロールをブロックします。 |
| Allow | ページやパスへのアクセスを許可します。例外処理に便利です。 |
| Sitemap | XML サイトマップの場所を検索エンジンのボットに伝えます。 |
| Crawl-delay | クローラーのリクエスト間の一時停止を提案します。サポート状況は検索エンジンによって異なる場合があります。 |
関連する無料ツール
注意
このジェネレーターは、選択したオプションに基づいて標準の robots.txt ファイルを作成します。公開する前に、最終的なコードを必ず注意深く確認してください。不適切なルールにより、検索エンジンがサイト上の重要なコンテンツにアクセスできなくなる可能性があります。