Get Source Code of Webpage
输入一个 URL
获取网页源代码
粘贴网址以检索页面源代码 — 适用于标记检查、快速审计、学习和技术检查。
获取源代码
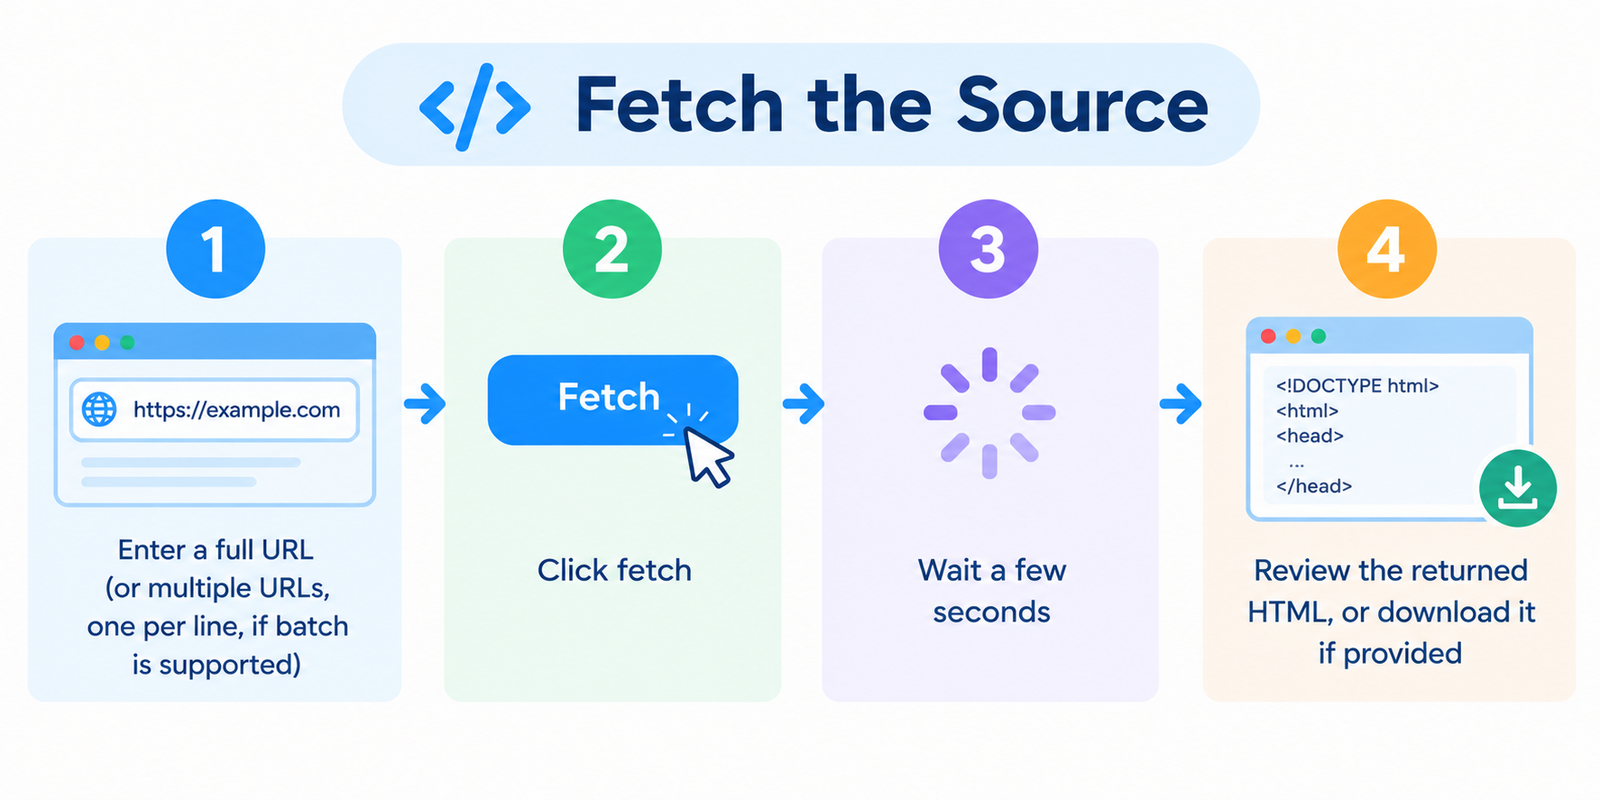
- 输入完整的网址(如果支持批量,可以输入多个网址,每行一个)
- 点击获取
- 等待几秒钟
- 查看返回的 HTML,或者在提供下载时将其下载
正常使用无需登录。
源代码与浏览器中所见内容的区别
这两者并不总是相同的。
| 视图 | 包含内容 |
|---|---|
| 原始 HTML 源代码 | 来自服务器的初始标记:标签、元数据、链接的资产、内联脚本 |
| 渲染后的 DOM | JavaScript 运行并更新页面后存在的内容 |
此工具用于获取源代码,而不是完全渲染的 JavaScript 运行后的 DOM 快照。
大量使用 React/Vue 等构建的现代应用程序在脚本执行之前,可能只会返回较少有实际意义的 HTML。
您可以在 HTML 中检查什么
获取源代码后,您可以查看:
- 标题(Title)、元描述(meta description)、规范标签(canonical)和机器人标签(robots tags)
- 标题结构和语义化标记
- 链接的 CSS/JS 文件和第三方脚本
- 图片路径和延迟加载属性
- 内联架构/JSON-LD 块
- 标记中留下的注释
- 原始代码中隐藏的或不寻常的链接模式
这是一种无需安装软件就能快速了解公共页面构建方式的方法。
实际用途
页面 SEO 检查
确认元标签、规范标签和结构化数据是否出现在初始 HTML 中。
技术审查
发现沉重的脚本堆栈、过时的引用或凌乱的标记模式。
学习 HTML 结构
研究真实网站如何组织页眉、导航、表单和内容块。
快速对比
保存今天的源代码,以便在网站改版或疑似更改后进行对比。
安全/信任筛选(基础)
查找公开页面上明显的、可疑的脚本或奇怪的嵌入内容 — 必要时使用适当的安全工具进行验证。
重要限制
- 无法获取受密码保护或仅限登录的页面
- 阻止自动化请求的网站可能会拒绝访问
- JavaScript 注入的内容可能不会出现在原始源代码中
- 输出反映的是请求时的响应(A/B 测试和个性化内容可能会有所不同)
- 使用检索到的代码时,请遵守网站条款、版权和适用法律
获取公开可用的 HTML 用于检查是很常见的。大规模重新发布或抓取可能会受到法律和道德上的限制。
获得更清晰分析的技巧
- 从您关心的确切网址开始(首页和文章页可能会有很大差异)
- 在源代码中搜索
meta、canonical、application/ld+json、gtag、googletagmanager - 如果 HTML 非常少,则该网站可能是客户端渲染的 — 请使用浏览器开发工具查看实时 DOM
- 在编辑器中格式化代码以便于阅读
- 结合其他检查(状态码、页面大小、元数据分析器)以获得更全面的了解
常见问题解答
这是免费的吗?
是的。标准使用不需要账户。
这与浏览器中的“查看网页源代码”相同吗?
概念上相似。其优势在于便利性以及可能支持多网址获取。浏览器的开发工具仍然更适合实时 DOM 检查。
为什么有些网站的 HTML 这么短?
许多现代网站只发送一个外壳页面,然后通过 JavaScript 加载内容。
我可以获取登录页面背后的源代码吗?
不能。只能获取公开可访问的响应。
该工具会执行 JavaScript 吗?
不会。它返回的是初始服务器响应,而不是完全渲染的交互式页面。
相关工具
注意: 返回的代码是公共服务器响应的一个快照。动态、地理定位或经过机器人过滤的页面可能会与您在自己的浏览器中看到的内容有所不同。