Get Source Code of Webpage
Entrez une URL
Obtenir le code source d'une page Web
Collez une URL pour récupérer le code source de la page — utile pour l'inspection du balisage, les audits rapides, l'apprentissage et les vérifications techniques.
Récupérer la source
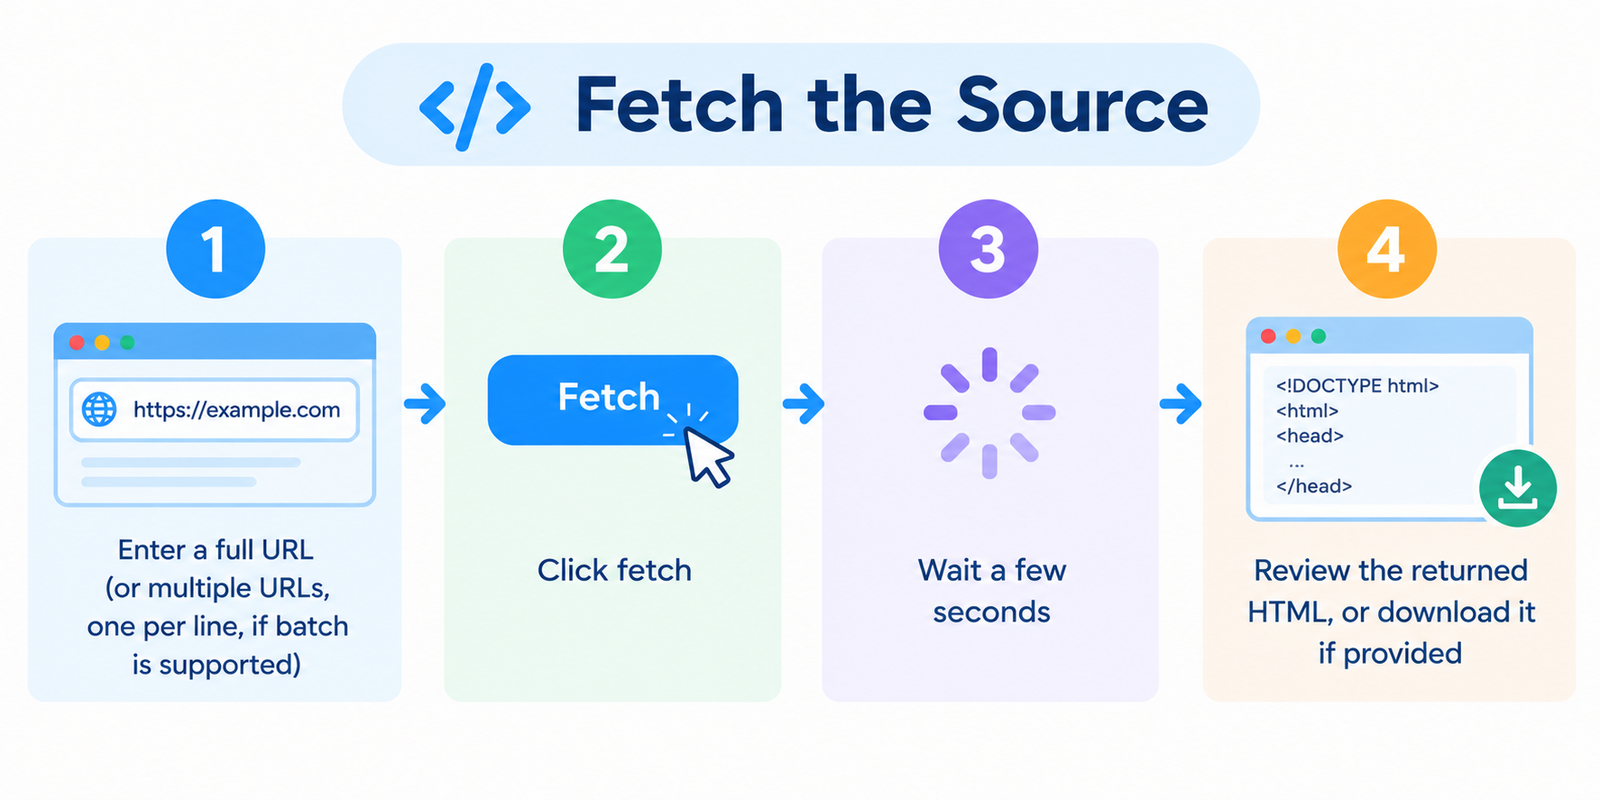
- Entrez une URL complète (ou plusieurs URL, une par ligne, si le traitement par lots est pris en charge)
- Cliquez sur récupérer
- Attendez quelques secondes
- Examinez le HTML renvoyé ou téléchargez-le s'il est fourni
Aucune connexion n'est requise pour une utilisation normale.
Code source vs Ce que vous voyez dans le navigateur
Ce n'est pas toujours la même chose.
| Vue | Ce qu'il contient |
|---|---|
| Source HTML brut | Balisage initial provenant du serveur : balises, métadonnées, actifs liés, scripts intégrés |
| DOM rendu | Ce qui existe après l'exécution de JavaScript et la mise à jour de la page |
Cet outil est conçu pour le code source, et non pour un instantané du DOM post-JavaScript entièrement rendu.
Les applications modernes construites principalement avec React/Vue/etc. peuvent renvoyer un code HTML relativement peu explicite tant que les scripts ne sont pas exécutés.
Ce que vous pouvez inspecter dans le code HTML
Une fois que vous avez le code source, vous pouvez rechercher :
- Le titre, la méta-description, les balises canonical et robots
- La structure des en-têtes et le balisage sémantique
- Les fichiers CSS/JS liés et les scripts tiers
- Les chemins des images et les attributs de chargement différé (lazy-load)
- Les blocs de données structurées intégrés / JSON-LD
- Les commentaires laissés dans le balisage
- Les schémas de liens cachés ou inhabituels dans le code brut
C'est un moyen rapide de comprendre comment une page publique est construite sans installer de logiciel.
Utilisations pratiques
Vérifications SEO on-page
Confirmez que les balises meta, canonicals et les données structurées apparaissent dans le code HTML initial.
Revue technique
Repérez les piles de scripts lourdes, les références obsolètes ou les structures de balisage désordonnées.
Apprentissage de la structure HTML
Étudiez la manière dont les sites réels organisent les en-têtes, la navigation, les formulaires et les blocs de contenu.
Comparaisons rapides
Enregistrez la source d'aujourd'hui et comparez-la plus tard après une refonte ou un changement suspect.
Filtrage de la sécurité / de la confiance (de base)
Recherchez des scripts suspects évidents ou du contenu intégré bizarre sur les pages publiques — puis vérifiez avec des outils de sécurité appropriés si nécessaire.
Limitations importantes
- Les pages protégées par mot de passe ou nécessitant une connexion ne peuvent pas être récupérées
- Les sites qui bloquent les requêtes automatisées peuvent refuser l'accès
- Le contenu injecté par JavaScript peut ne pas apparaître dans le code source brut
- Le résultat reflète la réponse au moment de la requête (les tests A/B et la personnalisation peuvent varier)
- Respectez les conditions d'utilisation du site Web, le droit d'auteur et les lois applicables lors de l'utilisation du code récupéré
La récupération de code HTML accessible au public est une pratique courante d'inspection. La republication ou le scraping à grande échelle peut comporter des limites juridiques et éthiques.
Conseils pour une analyse plus propre
- Commencez par l'URL exacte qui vous intéresse (la page d'accueil et la page d'un article peuvent différer considérablement)
- Recherchez dans le code source les éléments
meta,canonical,application/ld+json,gtag,googletagmanager - Si le code HTML est minime, le site est peut-être rendu côté client — utilisez les outils de développement du navigateur pour le DOM en direct
- Formatez le code dans un éditeur pour faciliter la lecture
- Combinez avec d'autres vérifications (code d'état, taille de la page, analyseur de meta) pour obtenir une image plus complète
FAQ
Est-ce gratuit ?
Oui. L'utilisation standard ne nécessite pas de compte.
Est-ce la même chose que « Afficher le code source de la page » dans un navigateur ?
Conceptuellement similaire. L'avantage est la commodité et la possibilité de récupérer plusieurs URL. Les outils de développement du navigateur restent meilleurs pour l'inspection du DOM en direct.
Pourquoi le code HTML est-il si court sur certains sites ?
De nombreux sites modernes envoient une page squelette et chargent le contenu à l'aide de JavaScript.
Puis-je obtenir la source de pages situées derrière une connexion ?
Non. Seules les réponses accessibles au public sont disponibles.
L'outil exécutera-t-il JavaScript ?
Non. Il renvoie la réponse initiale du serveur, et non une page interactive entièrement rendue.
Outils associés
- Analyseur de balises Meta
- Outil d'analyse des liens
- Vérificateur de taille de page
- Vérificateur d'état du serveur
- Générateur de captures d'écran de sites Web
Remarque : Le code renvoyé est un instantané de la réponse du serveur public. Les pages dynamiques, géolocalisées ou filtrées par des bots peuvent différer de ce que vous voyez dans votre propre navigateur.