Search Engine Spider Simulator
Introduce una URL
Simulador de araña de motores de búsqueda
Las personas ven el diseño, la distribución y las interacciones. Los rastreadores funcionan principalmente a partir del HTML obtenido: texto, enlaces y señales estructuradas.
Este simulador de araña gratuito obtiene una URL y muestra una vista simplificada y centrada en el texto de lo que un rastreador puede acceder más fácilmente desde el código fuente de la página.
Cómo utilizarlo
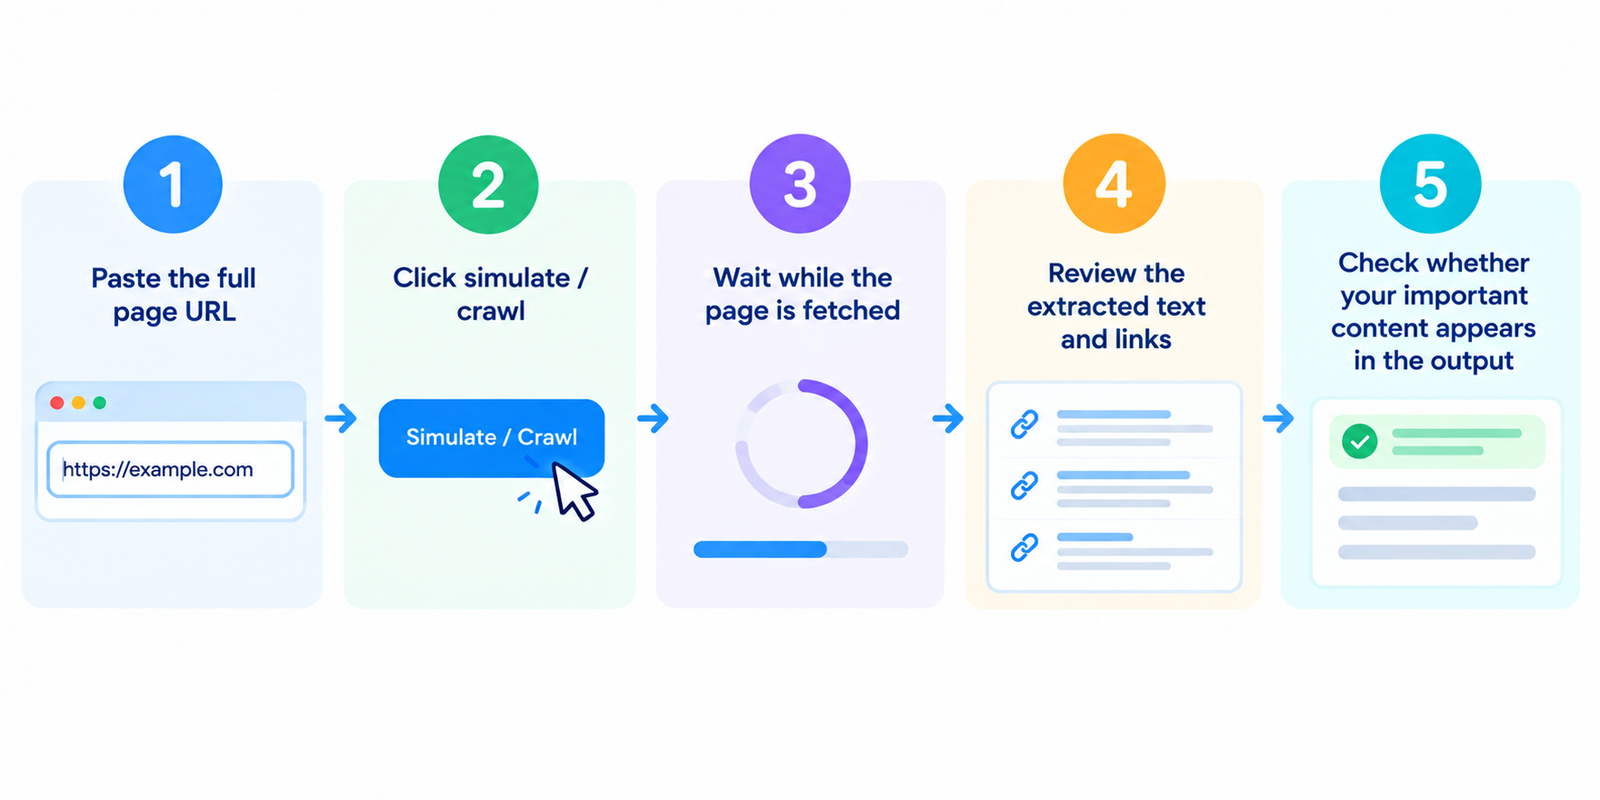
- Pega la URL completa de la página
- Haz clic en simular / rastrear
- Espera mientras se obtiene la página
- Revisa el texto y los enlaces extraídos
- Comprueba si tu contenido importante aparece en el resultado
Si el modo por lotes está disponible, prueba las plantillas clave: página principal, categorías, productos y páginas de artículos.
Qué intenta mostrar esta simulación
Una obtención al estilo de una araña suele priorizar:
| Elemento | Por qué es importante |
|---|---|
| Texto visible del HTML | Contenido principal disponible sin un renderizado pesado en el cliente |
| Enlaces de hipertexto (áncora) | Rutas que los rastreadores pueden descubrir a continuación |
| Señales de título / metadatos en el código fuente | Contexto inicial en la página dentro del HTML |
| Texto alternativo (Alt text) | Alternativas de texto para imágenes cuando se proporcionan |
| Estado HTTP | Si la URL responde correctamente |
Por lo general, no depende de un diseño CSS pulido ni de interacciones exclusivas del navegador.
Vista de araña frente a vista de navegador
| Vista de navegador | Vista de tipo araña |
|---|---|
| Página completa renderizada | Extracción de texto basada en el código fuente |
| Ejecuta scripts del lado del cliente | Puede perder contenido exclusivo de JS |
| Ve el diseño visual | Ignora los estilos |
| Menús/pestañas interactivos | Depende de enlaces reales en el HTML |
El Googlebot moderno puede procesar JavaScript mejor que los rastreadores antiguos, pero el contenido que aparece solo después de un renderizado de cliente complejo aún puede retrasarse, estar incompleto o ser más difícil de procesar. Hacer que el contenido importante esté disponible en el HTML inicial sigue siendo una práctica muy recomendada.
Qué comprobar en los resultados
¿Está presente tu contenido principal?
Los encabezados, los párrafos clave, los detalles de los productos y las preguntas frecuentes deben aparecer en el texto extraído.
¿Son visibles los enlaces internos importantes como enlaces reales?
La navegación y los enlaces contextuales deben existir como destinos href adecuados, no solo como controladores de clics.
¿La página está mayormente vacía en la vista de araña?
Eso puede indicar un renderizado pesado en el lado del cliente o contenido inyectado demasiado tarde.
¿Los códigos de estado parecen correctos?
El código 200 es ideal برای páginas indexables. Las cadenas de redireccionamiento, los errores 404 y las respuestas 5xx requieren atención.
¿Hay un exceso de contenido repetitivo (boilerplate)?
Los menús y los pies de página son normales, pero el contenido principal del cuerpo debe seguir siendo claro.
Problemas comunes que esto ayuda a detectar
- Contenido dependiente de JS — falta texto crítico en el HTML inicial
- Navegación sin enlaces — menús que no son verdaderos enlaces rastreables
- Texto extraído escaso — la página se ve rica visualmente pero tiene poco texto legible
- Destinos rotos o redirigidos — malos destinos de enlaces en la lista extraída
- Falta de texto alternativo (alt text) — imágenes sin equivalentes de texto
- Respuestas de estado inesperadas — URLs bloqueadas, faltantes o con errores
Utiliza el simulador como una advertencia temprana y luego verifícalo con Search Console y pruebas en vivo.
Consejos prácticos de mejora
- Asegúrate de que el contenido principal esté disponible en HTML renderizado en el servidor o prerenderizado cuando sea posible
- Utiliza enlaces reales para la navegación importante y las rutas internas
- Mantén las páginas indexables devolviendo respuestas limpias de código 200
- Agrega texto alternativo significativo donde las imágenes transmitan información
- Evita depender de “hacer clic para cargar” para contenido SEO esencial
- Vuelve a realizar pruebas después de rediseños, cambios de temas o actualizaciones de frameworks de JS
Para comprobaciones técnicas más profundas, combínalo con herramientas de código fuente, estado e indexación.
Preguntas frecuentes
¿Esta herramienta es gratuita?
Sí. Las simulaciones estándar no requieren una cuenta.
¿Es exactamente así como Googlebot ve mi página?
No exactamente. Es una vista simplificada al estilo de una araña. Los sistemas de Google son más avanzados y pueden renderizar JavaScript, pero esto sigue siendo útil para detectar grandes deficiencias de contenido y enlaces.
¿Por qué mi texto no aparece aquí pero es visible en el navegador?
Es posible que el contenido se cargue solo después de que se ejecute el JavaScript del lado del cliente.
¿Puede esto rastrear todo mi sitio web?
La mayoría de las versiones gratuitas analizan una página a la vez. Prueba URLs representativas de cada plantilla.
¿Una buena vista de araña garantiza la clasificación?
No. Solo ayuda a confirmar que el contenido y los enlaces son descubribles. La relevancia, la calidad y la competencia siguen decidiendo las posiciones.
Herramientas relacionadas
- Obtener el código fuente de una página web
- Verificador de índice de Google
- Buscador de enlaces rotos
- Generador de Robots.txt
- Analizador de metaetiquetas
Nota: Los resultados de la simulación dependen de la respuesta HTML obtenida. La protección contra bots, la personalización y las aplicaciones renderizadas en el cliente pueden afectar lo que aparece.