Search Engine Spider Simulator
輸入一個 URL
搜尋引擎蜘蛛模擬器
人類見到的是設計、排版同互動。而爬蟲主要透過獲取的 HTML 來運作:文字、連結同結構化訊號。
呢個免費嘅蜘蛛模擬器會擷取一個網址,並顯示出簡化、以文字為主嘅檢視畫面,等你知道爬蟲可以喺網頁原始碼中輕鬆存取到咩內容。
點樣使用
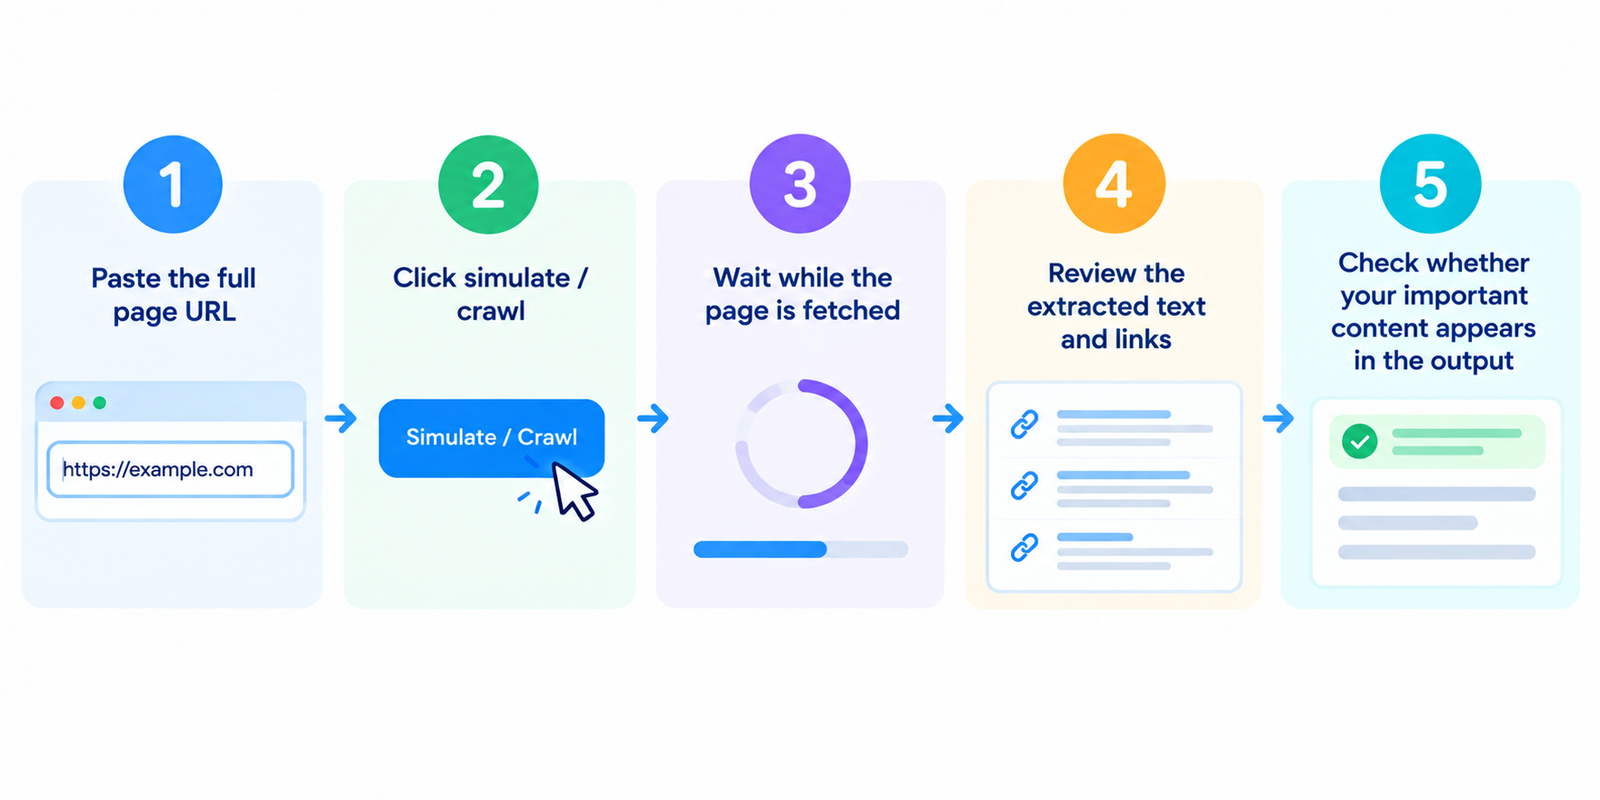
- 貼上完整的網頁網址
- 點擊模擬 / 爬取
- 等待網頁載入完成
- 檢閱提取出來的文字同連結
- 檢查你重要的內容有冇喺輸出結果中出現
如果批次模式可用,請測試主要的範本:主頁、分類頁、產品頁同文章頁。
呢個模擬器想展示啲乜
蜘蛛類型的擷取通常會優先處理:
| 元素 | 點解重要 |
|---|---|
| 來自 HTML 的可見文字 | 唔需要大量客戶端渲染即可取得的核心內容 |
| 錨點連結 | 爬蟲接下來可以發現的路徑 |
| 原始碼中的標題 / Meta 訊號 | HTML 中的早期頁面內文脈絡 |
| 替代文字 (Alt text) | 提供時圖片的文字替代方案 |
| HTTP 狀態 | 網址的回應是否正常 |
它通常唔會依賴精美的 CSS 排版或純瀏覽器互動。
蜘蛛檢視與瀏覽器檢視
| 瀏覽器檢視 | 蜘蛛風格檢視 |
|---|---|
| 完整渲染的網頁 | 基於原始碼的文字提取 |
| 執行客戶端腳本 | 可能會遺漏純 JS 的內容 |
| 睇到視覺設計 | 忽略樣式 |
| 互動式選單/分頁 | 取決於 HTML 中的真實連結 |
現代的 Googlebot 比舊版爬蟲更能處理 JavaScript,但只喺複雜嘅客戶端渲染之後先出現嘅內容,仍然可能會被延遲、唔完整或更難處理。確保重要內容喺初始 HTML 中就存在,仍然係一項好重要嘅做法。
檢查結果時要注意乜嘢
你的主要內容是否存在?
標題、關鍵段落、產品詳細資料同常見問題 (FAQ) 都應該喺提取出的文字中出現。
重要嘅內部連結有冇被視為真實連結顯示?
導覽同上下文連結應該作為正確嘅 href 目標存在,而不單止係點擊處理常式 (click handlers)。
網頁喺蜘蛛檢視中係咪大部分空白?
呢個可能表示有大量客戶端渲染,或者內容載入得太遲。
狀態碼睇落正唔正常?
200 係可索引網頁嘅理想狀態。重新導向鏈 (Redirect chains)、404 同 5xx 回應需要特別注意。
係咪有太多重複嘅樣板內容 (boilerplate)?
選單同頁尾係正常嘅,但獨特嘅內文主體仍然應該清晰易讀。
有助浮現嘅常見問題
- 依賴 JS 的內容 — 初始 HTML 中缺少關鍵文字
- 非連結導覽 — 唔係真正可爬取連結嘅選單
- 提取出的文字太少 — 網頁視覺上好豐富,但可讀嘅複製文字好少
- 損壞或被重新導向的目標 — 提取清單中嘅不良連結目的地
- 缺少替代文字 (Alt text) — 圖片缺乏文字替代說明
- 未預期的狀態回應 — 被封鎖、不存在或出錯嘅網址
將呢個模擬器用作早期警告,然後再透過 Search Console 同實時測試進行驗證。
實用嘅改善建議
- 盡可能確保主要內容喺伺服器渲染或預渲染嘅 HTML 中可用
- 為重要嘅導覽同內部路徑使用真實嘅連結
- 保持可索引網頁傳回乾淨嘅 200 回應
- 當圖片傳達資訊時,新增有意義嘅替代文字 (Alt text)
- 避免依賴「點擊載入」來處理必要的 SEO 內容
- 在重新設計、主題變更或 JS 框架更新後重新測試
如需進行更深入嘅技術檢查,請將呢個工具與原始碼、狀態同索引工具配合使用。
常見問題
呢個工具係免費嘅嗎?
係。標準模擬唔需要建立帳戶。
呢個就係 Googlebot 睇我網頁嘅完全方式嗎?
唔係完全一樣。呢個只係一個簡化的蜘蛛風格檢視。Google 嘅系統更先進,可能會渲染 JavaScript,但呢個工具對於找出主要的內容/連結缺口仍然好有用。
點解我嘅文字喺呢度睇唔到,但喺瀏覽器度睇到?
該內容可能只喺客戶端 JavaScript 執行後先至載入。
呢個工具可以爬取我嘅整個網站嗎?
大多數免費版本一次只能分析一個網頁。請測試每個範本中有代表性的網址。
良好嘅蜘蛛檢視能否保證排名?
唔會。它只係有助於確認內容同連結係可以被發現嘅。關聯性、質素同競爭先至決定排名。
相關工具
注意:模擬結果取決於獲取的 HTML 回應。機械人防護、個人化同客戶端渲染應用程式可能會影響顯示嘅內容。