Search Engine Spider Simulator
Inserisci un URL
Simulatore di Crawler per Motori di Ricerca
Le persone vedono il design, il layout e le interazioni. I crawler lavorano principalmente sull'HTML recuperato: testo, link e segnali strutturati.
Questo simulatore di crawler gratuito recupera un URL e mostra una vista semplificata e incentrata sul testo di ciò a cui un crawler può accedere più facilmente dal codice sorgente della pagina.
Come si usa
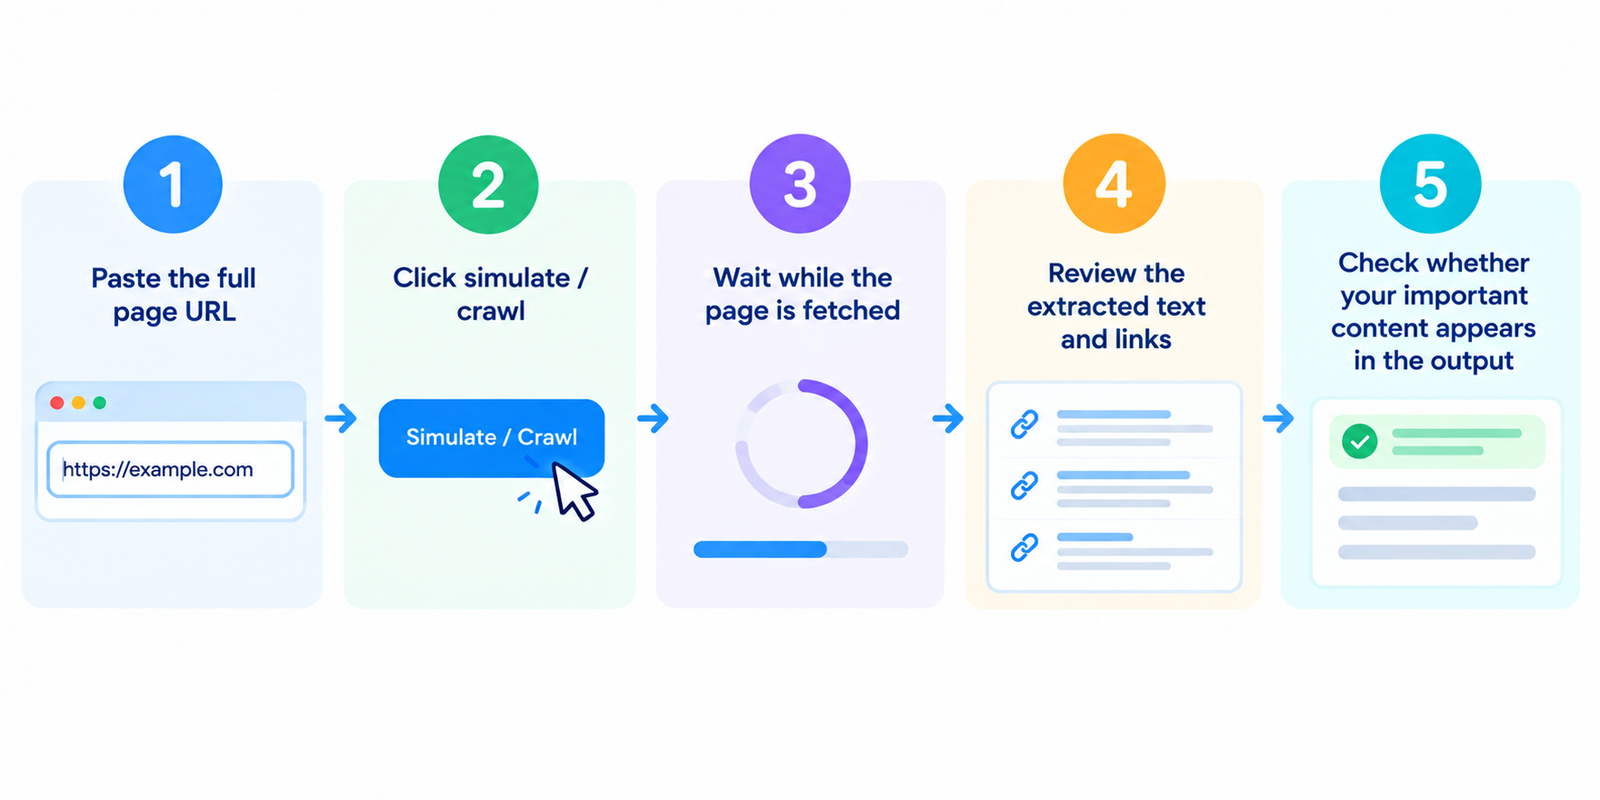
- Incolla l'URL completo della pagina
- Fai clic su simula / esegui il crawler
- Attendi il caricamento della pagina
- Verifica il testo e i link estratti
- Controlla se i tuoi contenuti importanti compaiono nell'output
Se la modalità batch è disponibile, testa i template chiave: home page, categoria, prodotto e pagine di articoli.
Cosa cerca di mostrare questa simulazione
Un recupero in stile crawler dà solitamente la priorità a:
| Elemento | Perché è importante |
|---|---|
| Testo visibile dall'HTML | Contenuto principale disponibile senza pesante rendering lato client |
| Link di ancoraggio | Percorsi che i crawler possono scoprire successivamente |
| Segnali di titolo / meta nel codice sorgente | Contesto iniziale on-page nell'HTML |
| Testo alternativo (Alt text) | Alternative testuali per le immagini, se fornite |
| Stato HTTP | Se l'URL risponde correttamente |
Solitamente non si basa su un layout CSS rifinito o su interazioni eseguite solo dal browser.
Vista Crawler vs Vista Browser
| Vista browser | Vista in stile crawler |
|---|---|
| Pagina interamente renderizzata | Estrazione del testo basata sul codice sorgente |
| Esegue script lato client | Potrebbe perdere contenuti basati solo su JS |
| Visualizza il design grafico | Ignora lo stile |
| Menu/schede interattivi | Dipende dai link reali presenti nell'HTML |
Il Googlebot moderno è in grado di elaborare JavaScript meglio rispetto ai vecchi crawler, ma i contenuti che compaiono solo dopo un complesso rendering lato client possono comunque subire ritardi, essere incompleti o più difficili da elaborare. Rendere i contenuti importanti disponibili nell'HTML iniziale rimane una solida pratica.
Cosa controllare nei risultati
Il tuo contenuto principale è presente?
Intestazioni, paragrafi chiave, dettagli dei prodotti e FAQ dovrebbero apparire nel testo estratto.
Gli importanti link interni sono visibili come veri link?
La navigazione e i link contestuali dovrebbero esistere come veri e propri target href, non solo come gestori di clic.
La pagina appare prevalentemente vuota nella vista del crawler?
Ciò potrebbe indicare un pesante rendering lato client o contenuti iniettati troppo tardi.
I codici di stato sembrano corretti?
200 è l'ideale per le pagine indicizzabili. Catene di reindirizzamento, errori 404 e risposte 5xx richiedono attenzione.
C'è una quantità eccessiva di boilerplate (codice ripetitivo)?
Menu e piè di pagina sono normali, ma il contenuto principale del corpo della pagina dovrebbe comunque risultare chiaro.
Problemi comuni che questo strumento aiuta a evidenziare
- Contenuti dipendenti da JS — testo critico mancante dall'HTML iniziale
- Navigazione senza link — menu che non sono veri link scansionabili
- Testo estratto ridotto — la pagina appare ricca visivamente ma ha poco testo leggibile
- Destinazioni rotte o reindirizzate — cattive destinazioni dei link nell'elenco estratto
- Testo alternativo mancante — immagini prive di equivalenti testuali
- Risposte di stato impreviste — URL bloccati, mancanti o che restituiscono errori
Usa il simulatore come un sistema di avviso precoce, quindi verifica con Search Console e test dal vivo.
Consigli pratici per il miglioramento
- Assicurati che il contenuto principale sia disponibile in HTML renderizzato dal server o pre-renderizzato, quando possibile
- Usa link reali per la navigazione importante e per i percorsi interni
- Fai in modo che le pagine indicizzabili restituiscano risposte 200 pulite
- Aggiungi un testo alternativo significativo laddove le immagini trasmettono informazioni
- Evita di affidarti a “clicca per caricare” per i contenuti SEO essenziali
- Ripeti il test dopo riprogettazioni, modifiche ai temi o aggiornamenti di framework JS
Per controlli tecnici più approfonditi, abbina questo strumento ad analisi del codice sorgente, dello stato e degli strumenti di indicizzazione.
FAQ
Questo strumento è gratuito?
Sì. Le simulazioni standard non richiedono un account.
È esattamente così che Googlebot vede la mia pagina?
Non esattamente. Si tratta di una vista semplificata in stile crawler. I sistemi di Google sono più avanzati e potrebbero eseguire JavaScript, ma questo strumento rimane utile per individuare gravi lacune nei contenuti o nei link.
Perché il mio testo è assente qui ma visibile nel browser?
Il contenuto potrebbe essere caricato solo dopo l'esecuzione di JavaScript lato client.
Questo strumento può scansionare tutto il mio sito web?
La maggior parte delle versioni gratuite analizza una pagina alla volta. Testa URL rappresentativi di ogni template.
Una buona visualizzazione da crawler garantisce il posizionamento?
No. Aiuta solo a confermare che contenuti e link siano scansionabili. Rilevanza, qualità e concorrenza continuano a determinare il posizionamento.
Strumenti correlati
- Ottieni il codice sorgente della pagina web
- Verificatore indice Google
- Trova link rotti
- Generatore Robots.txt
- Analizzatore di meta tag
Nota: I risultati della simulazione dipendono dalla risposta HTML ricevuta. La protezione dai bot, la personalizzazione e le app renderizzate lato client possono influenzare ciò che viene visualizzato.