Search Engine Spider Simulator
Введите URL
Симулятор поискового паука
Люди видят дизайн, макет и элементы взаимодействия. Поисковые роботы (краулеры) в основном работают с полученным HTML-кодом: текстом, ссылками и структурированными сигналами.
Этот бесплатный симулятор паука загружает URL-адрес и показывает упрощенное, ориентированное на текст представление того, к чему краулер может получить доступ из исходного кода страницы с наибольшей легкостью.
Как им пользоваться
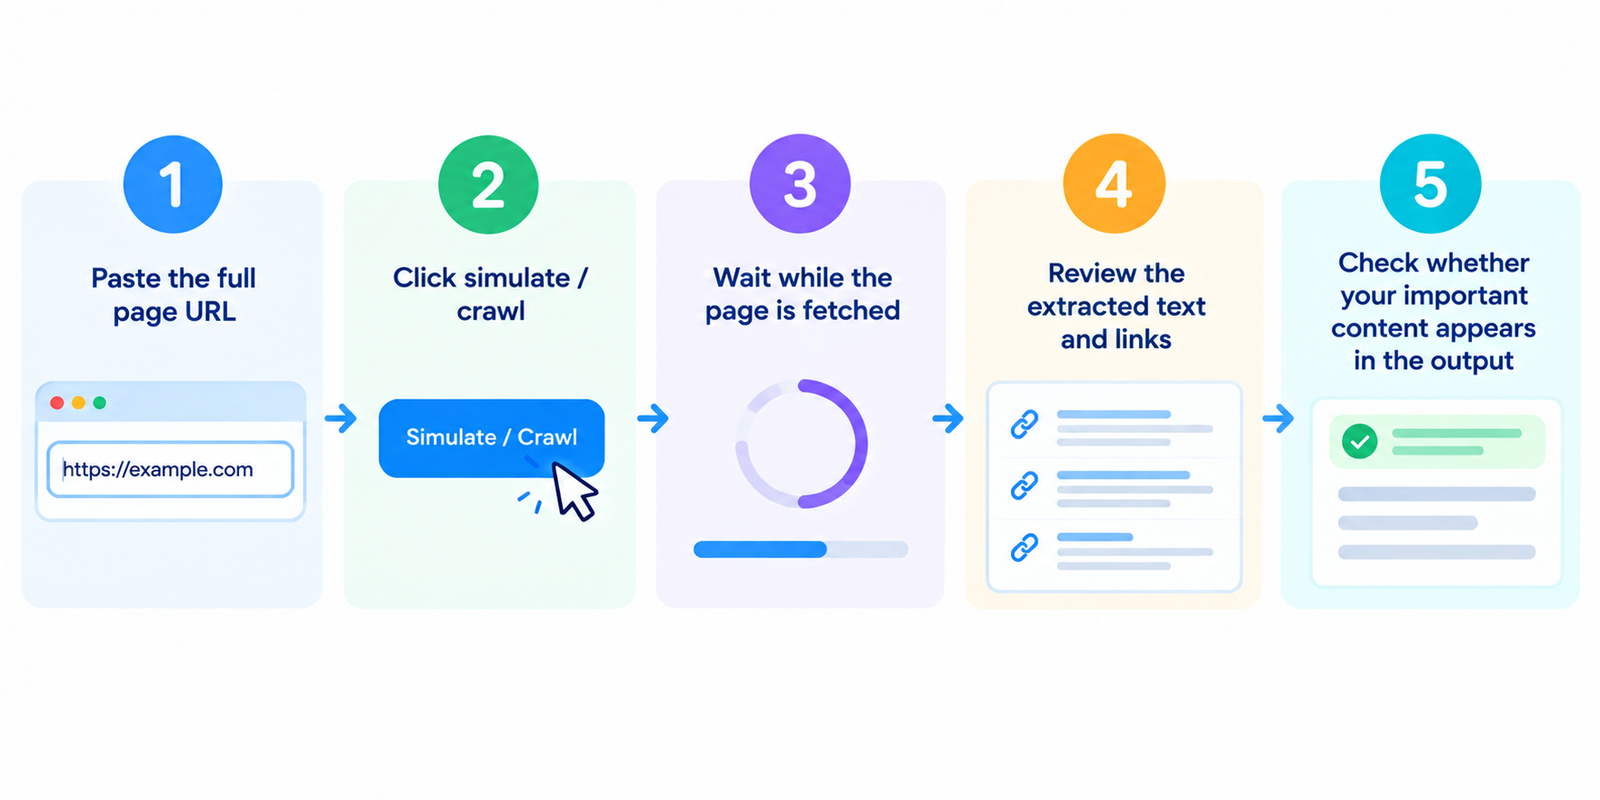
- Вставьте полный URL-адрес страницы
- Нажмите «симулировать» / «сканировать»
- Подождите, пока страница загружается
- Изучите извлеченный текст и ссылки
- Проверьте, появляется ли ваш важный контент в результатах
Если доступен пакетный режим, протестируйте ключевые шаблоны: главную страницу, страницы категорий, товаров и статей.
Что эта симуляция пытается показать
Загрузка в стиле поискового паука обычно отдает приоритет:
| Элемент | Почему это важно |
|---|---|
| Видимый текст из HTML | Основной контент доступен без сложного клиентского рендеринга |
| Якорные ссылки | Пути, которые краулеры могут обнаружить далее |
| Сигналы title / meta в исходном коде | Первичный контекст на странице в HTML |
| Alt-текст | Текстовые альтернативы для изображений, если они предоставлены |
| HTTP-статус | Корректно ли отвечает URL-адрес |
Она обычно не полагается на отполированный CSS-макет или взаимодействия только на стороне браузера.
Вид глазами паука против вида в браузере
| Вид в браузере | Вид в стиле паука |
|---|---|
| Полностью отрендеренная страница | Извлечение текста на основе исходного кода |
| Запускает скрипты на стороне клиента | Может пропустить контент, работающий только на JS |
| Видит визуальный дизайн | Игнорирует стили |
| Интерактивные меню/вкладки | Зависит от реальных ссылок в HTML |
Современный Googlebot может обрабатывать JavaScript лучше, чем старые краулеры, но контент, который появляется только после сложного клиентского рендеринга, все равно может задерживаться, быть неполным или обрабатываться с трудом. Доступность важного контента в первоначальном HTML-коде остается надежной практикой.
Что проверить в результатах
Присутствует ли ваш основной контент?
Заголовки, ключевые абзацы, сведения о товаре и часто задаваемые вопросы должны отображаться в извлеченном тексте.
Видны ли важные внутренние ссылки как настоящие ссылки?
Навигация и контекстные ссылки должны существовать в виде правильных целей href, а не только как обработчики кликов.
Является ли страница в основном пустой в режиме просмотра пауком?
Это может указывать на тяжелый клиентский рендеринг или слишком поздно внедряемый контент.
Выглядят ли коды состояния нормальными?
200 — идеальный вариант для индексируемых страниц. Цепочки перенаправлений, 404 и ответы 5xx требуют внимания.
Нет ли избыточного шаблонного кода (бойлерплейта)?
Меню и подвалы — это нормально, но уникальный контент основного текста все равно должен быть четким.
Распространенные проблемы, которые помогает выявить этот инструмент
- Контент, зависящий от JS — критически важный текст отсутствует в первоначальном HTML
- Не ссылочная навигация — меню, которые не являются настоящими сканируемыми ссылками
- Скудный извлеченный текст — страница выглядит визуально насыщенной, но имеет мало читаемого текста
- Сломанные или перенаправленные цели — неудачные пункты назначения ссылок в извлеченном списке
- Отсутствующий alt-текст — изображения без текстовых эквивалентов
- Неожиданные ответы состояния — заблокированные, отсутствующие или возвращающие ошибки URL-адреса
Используйте симулятор в качестве системы раннего предупреждения, а затем проверяйте результаты с помощью Search Console и тестирования в реальном времени.
Практические советы по улучшению
- Убедитесь, что основной контент доступен в отрендеренном на сервере или предварительно отрендеренном HTML, когда это возможно
- Используйте настоящие ссылки для важной навигации и внутренних путей
- Сделайте так, чтобы индексируемые страницы возвращали чистые ответы 200
- Добавляйте содержательный alt-текст там, где изображения несут информацию
- Избегайте использования принципа «нажмите для загрузки» для важного SEO-контента
- Проводите повторное тестирование после редизайнов, смены тем или обновлений JS-фреймворков
Для более глубоких технических проверок используйте этот инструмент в сочетании с инструментами анализа исходного кода, статуса и индексации.
Часто задаваемые вопросы
Бесплатный ли этот инструмент?
Да. Стандартные симуляции не требуют учетной записи.
Именно так Googlebot видит мою страницу?
Не совсем. Это упрощенное представление в стиле паука. Системы Google более продвинуты и могут выполнять рендеринг JavaScript, но этот инструмент остается полезным для обнаружения серьезных пробелов в контенте/ссылках.
Почему мой текст отсутствует здесь, но виден в браузере?
Контент может загружаться только после запуска JavaScript на стороне клиента.
Может ли это просканировать весь мой сайт?
Большинство бесплатных версий анализируют по одной странице за раз. Тестируйте репрезентативные URL-адреса из каждого шаблона.
Гарантирует ли хороший вид для паука высокие позиции в рейтинге?
Нет. Это лишь помогает подтвердить, что контент и ссылки доступны для обнаружения. Позиции в рейтинге по-прежнему определяются релевантностью, качеством и конкуренцией.
Связанные инструменты
- Получить исходный код веб-страницы
- Проверка индексации Google
- Поиск битых ссылок
- Генератор Robots.txt
- Анализатор мета-тегов
Примечание: Результаты симуляции зависят от ответа полученного HTML. Защита от ботов, персонализация и приложения с клиентским рендерингом могут повлиять на то, что отображается.