Search Engine Spider Simulator
输入一个 URL
搜索引擎蜘蛛模拟器
人们看到的是设计、布局和交互。而爬虫主要通过获取的 HTML 来工作:文本、链接和结构化信号。
这个免费的蜘蛛模拟器可以获取网址(URL),并显示一个简化的、以文本为中心的视图,展示爬虫从页面源码中能更轻易访问到什么内容。
如何使用
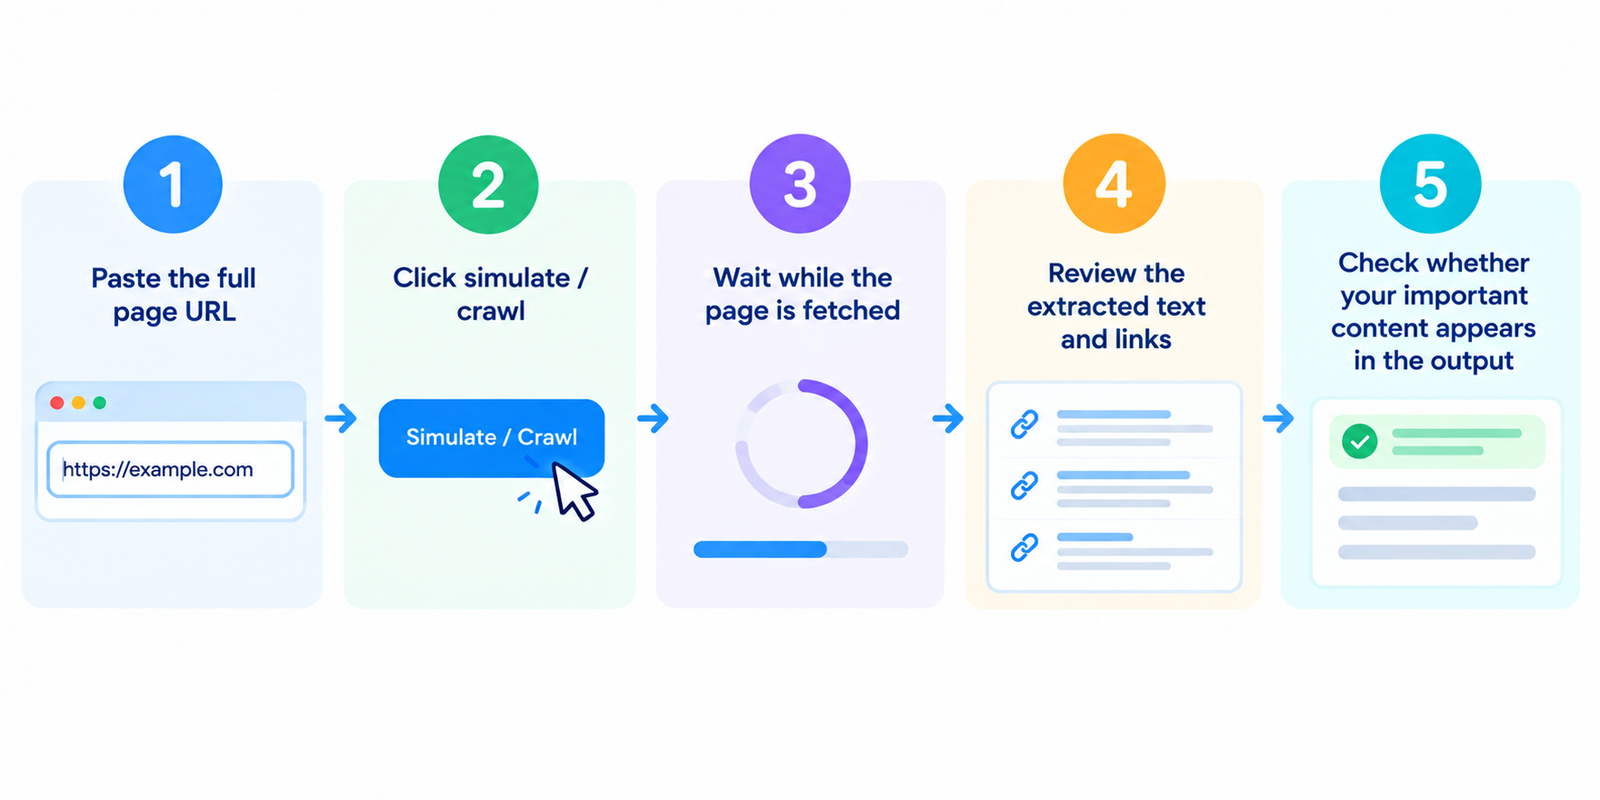
- 粘贴完整的页面网址
- 点击模拟 / 抓取
- 等待页面获取完成
- 检查提取出的文本和链接
- 检查您的重要内容是否出现在输出结果中
如果支持批量模式,请测试核心模板:主页、分类页、产品页和文章页。
本模拟试图展示什么
类似蜘蛛的抓取通常会优先处理:
| 元素 | 为什么重要 |
|---|---|
| HTML 中的可见文本 | 无需大量客户端渲染即可获得的核心内容 |
| 锚文本链接 | 爬虫接下来可以发现的路径 |
| 源码中的标题 / 元信号 | HTML 中的早期页面上下文 |
| Alt 文本 | 提供图片时的文本替代方案 |
| HTTP 状态 | 网址是否能正常干净地响应 |
它通常不依赖于精美的 CSS 布局或纯浏览器交互。
蜘蛛视图与浏览器视图
| 浏览器视图 | 蜘蛛样式视图 |
|---|---|
| 完整渲染的页面 | 基于源码的文本提取 |
| 运行客户端脚本 | 可能会遗漏纯 JS 内容 |
| 看到视觉设计 | 忽略样式 |
| 交互式菜单/标签页 | 取决于 HTML 中的真实链接 |
现代 Googlebot 处理 JavaScript 的能力比以往的爬虫更强,但仅在复杂的客户端渲染之后才显示的内容仍然可能会被延迟、不完整或更难处理。将重要内容放在初始 HTML 中依然是一个强大的最佳实践。
结果中需要检查什么
您的主要内容是否存在?
标题、关键段落、产品详情和常见问题(FAQ)应出现在提取的文本中。
重要的内部链接是否显示为真正的链接?
导航和上下文链接应作为正确的 href 目标存在,而不仅仅是点击处理程序。
页面在蜘蛛视图中是否大多为空白?
这可能表明存在大量客户端渲染或内容注入得太晚。
状态码看起来健康吗?
200 是可索引页面的理想状态。重定向链、404 和 5xx 响应需要予以关注。
是否存在过多的样板文件?
菜单和页脚是正常的,但独特的主体内容仍应清晰明了。
这有助于发现的常见问题
- 依赖 JS 的内容 — 初始 HTML 中缺少关键文本
- 非链接导航 — 不是真正可抓取链接的菜单
- 提取的文本稀疏 — 页面视觉上很丰富,但可读的正文很少
- 损坏或重定向的目标 — 提取列表中存在不良的链接目的地
- 缺少 alt 文本 — 没有文本等效项的图片
- 意外的状态响应 — 被阻止、丢失或报错的网址
将此模拟器用作早期预警,然后通过 Search Console 和实时测试进行验证。
实用改进建议
- 尽可能确保主要内容在服务器端渲染或预渲染的 HTML 中可用
- 为重要的导航和内部路径使用真正的链接
- 保持可索引页面返回干净的 200 响应
- 在图片传达信息的地方添加有意义的 alt 文本
- 避免对必要的 SEO 内容依赖“点击加载”
- 在重新设计、主题更改或 JS 框架更新后重新测试
如需更深入的技术检查,请将其与源码、状态和索引工具结合使用。
常见问题
这个工具是免费的吗?
是的。标准模拟不需要账号。
这完全是 Googlebot 查看我页面的方式吗?
不完全是。这是一个简化的蜘蛛样式视图。Google 的系统更为先进,可能会渲染 JavaScript,但这对发现主要的 conteudo/链接漏洞仍然很有用。
为什么我的文本在这里丢失了但在浏览器中可见?
该内容可能仅在客户端 JavaScript 运行后才加载。
这可以抓取我的整个网站吗?
大多数免费版本一次分析一个页面。请测试每个模板的代表性网址。
良好的蜘蛛视图能保证排名吗?
不能。它仅有助于确认内容和链接是可被发现的。相关性、质量和竞争仍然决定着排名。
相关工具
注意:模拟结果取决于获取到的 HTML 响应。机器人防护、个性化和客户端渲染的应用可能会影响显示的内容。