Search Engine Spider Simulator
Insira um URL
Simulador de Spider de Mecanismo de Busca
As pessoas veem o design, o layout e as interações. Os rastreadores funcionam principalmente a partir do HTML obtido: texto, links e sinais estruturados.
Este simulador de spider gratuito busca um URL e mostra uma visão simplificada e focada em texto do que um rastreador pode acessar mais facilmente a partir do código-fonte da página.
Como Usar
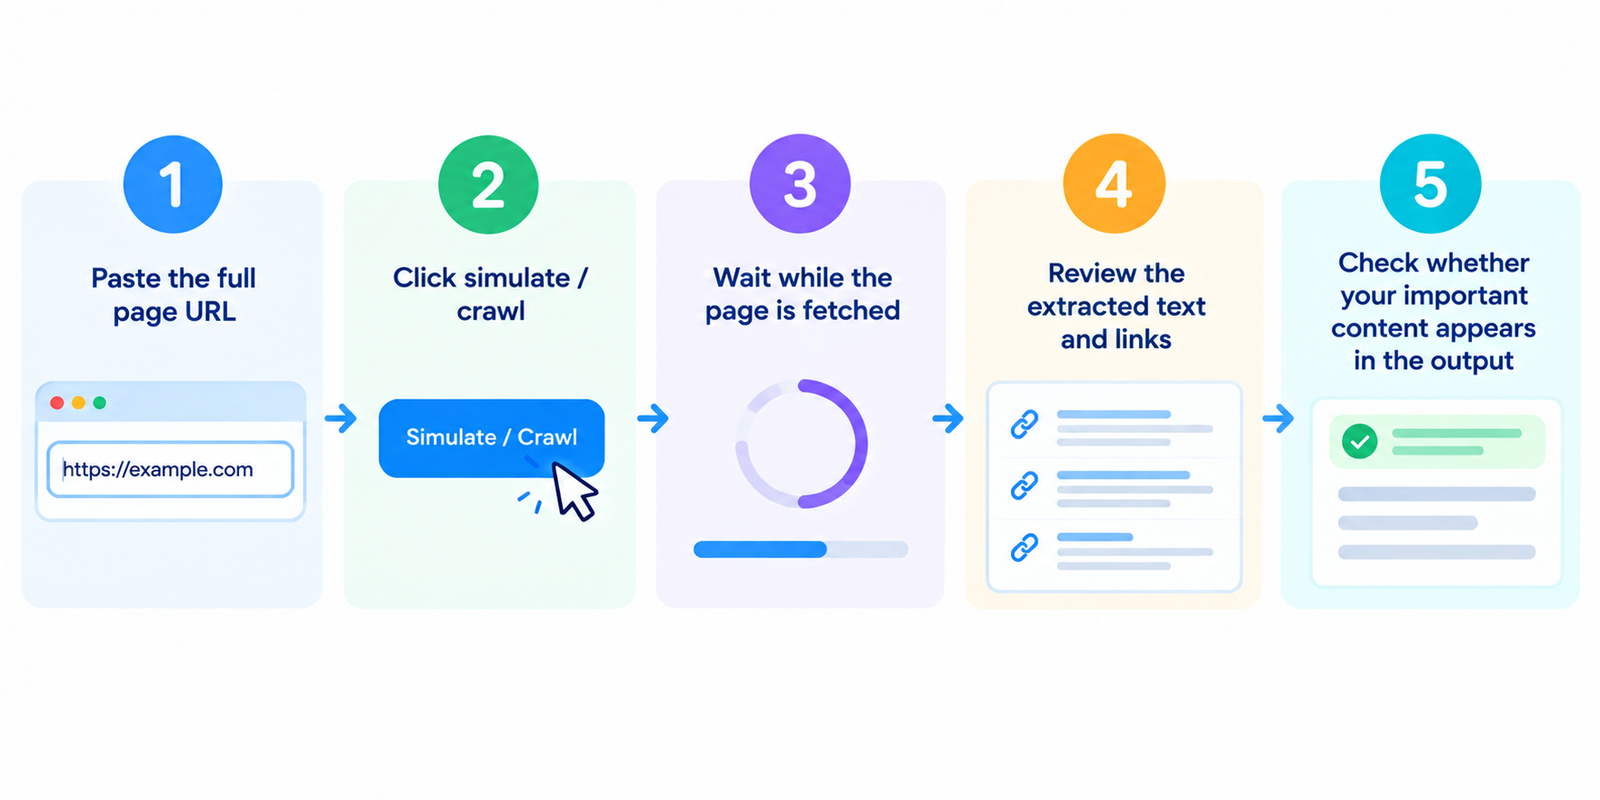
- Cole o URL completo da página
- Clique em simular / rastrear
- Aguarde enquanto a página é obtida
- Revise o texto e os links extraídos
- Verifique se o seu conteúdo importante aparece no resultado
Se o modo em lote estiver disponível, teste os principais modelos: página inicial, categoria, produto e páginas de artigos.
O Que Esta Simulação Tenta Mostrar
Uma busca no estilo spider normalmente prioriza:
| Elemento | Por que importa |
|---|---|
| Texto visível do HTML | Conteúdo principal disponível sem renderização pesada no cliente |
| Links de âncora | Caminhos que os rastreadores podem descobrir em seguida |
| Sinais de título / meta no código-fonte | Contexto inicial na página dentro do HTML |
| Texto Alt | Alternativas de texto para imagens quando fornecidas |
| Status HTTP | Se o URL responde corretamente |
Normalmente, ele não depende de um layout CSS polido ou de interações exclusivas do navegador.
Visualização do Spider vs. Visualização do Navegador
| Visualização do navegador | Visualização estilo spider |
|---|---|
| Página totalmente renderizada | Extração de texto baseada no código-fonte |
| Executa scripts do lado do cliente | Pode perder conteúdo apenas em JS |
| Vê o design visual | Ignora a estilização |
| Menus/abas interativos | Depende de links reais no HTML |
O Googlebot moderno pode processar JavaScript melhor do que os rastreadores mais antigos, mas o conteúdo que aparece apenas após uma renderização complexa do lado do cliente ainda pode ser atrasado, incompleto ou mais difícil de processar. Disponibilizar o conteúdo importante no HTML inicial continua sendo uma prática recomendada.
O Que Verificar nos Resultados
O seu conteúdo principal está presente?
Cabeçalhos, parágrafos principais, detalhes de produtos e FAQs devem aparecer no texto extraído.
Os links internos importantes estão visíveis como links reais?
A navegação e os links contextuais devem existir como destinos href adequados, e não apenas manipuladores de clique.
A página está quase vazia na visualização do spider?
Isso pode indicar renderização pesada do lado do cliente ou conteúdo injetado muito tarde.
Os códigos de status parecem saudáveis?
200 é o ideal para páginas indexáveis. Cadeias de redirecionamento, erros 404 e respostas 5xx precisam de atenção.
Há excesso de código padrão (boilerplate)?
Menus e rodapés são normais, mas o conteúdo principal do corpo ainda deve estar claro.
Problemas Comuns que Isso Ajuda a Identificar
- Conteúdo dependente de JS — texto crítico ausente no HTML inicial
- Navegação sem links — menus que não são verdadeiros links rastreáveis
- Texto extraído insuficiente — a página parece rica visualmente, mas tem pouco texto legível
- Destinos quebrados ou redirecionados — destinos de links ruins na lista extraída
- Texto alt ausente — imagens sem equivalentes textuais
- Respostas de status inesperadas — URLs bloqueadas, ausentes ou com erro
Use o simulador como um aviso prévio e, em seguida, verifique com o Search Console e testes ao vivo.
Dicas Práticas de Melhoria
- Garanta que o conteúdo principal esteja disponível em HTML renderizado no servidor ou pré-renderizado, quando possível
- Use links reais para navegação importante e caminhos internos
- Mantenha as páginas indexáveis retornando respostas 200 limpas
- Adicione texto alt significativo onde as imagens transmitem informações
- Evite depender de “clique para carregar” para conteúdo essencial de SEO
- Teste novamente após redesigns, alterações de temas ou atualizações de frameworks JS
Para verificações técnicas mais profundas, combine isso com ferramentas de código-fonte, status e índice.
FAQ
Esta ferramenta é gratuita?
Sim. As simulações padrão não exigem uma conta.
É exatamente assim que o Googlebot vê a minha página?
Não exatamente. É uma visualização simplificada no estilo spider. Os sistemas do Google são mais avançados e podem renderizar JavaScript, mas isso continua útil para identificar grandes lacunas de conteúdo/links.
Por que meu texto está faltando aqui, mas está visível no navegador?
O conteúdo pode ser carregado somente após a execução do JavaScript no lado do cliente.
Isso pode rastrear todo o meu site?
A maioria das versões gratuitas analisa uma página por vez. Teste URLs representativos de cada modelo.
Uma boa visualização de spider garante o posicionamento?
Não. Ela apenas ajuda a confirmar se o conteúdo e os links são descobríveis. A relevância, a qualidade e a concorrência ainda decidem as posições.
Ferramentas relacionadas
- Obter Código-Fonte da Página Web
- Verificador de Índice do Google
- Localizador de Links Quebrados
- Gerador de Robots.txt
- Analisador de Meta Tags
Nota: Os resultados da simulação dependem da resposta HTML obtida. A proteção contra bots, a personalização e os aplicativos renderizados pelo cliente podem afetar o que é exibido.