Search Engine Spider Simulator
Entrez une URL
Simulateur d'araignée de moteur de recherche
Les utilisateurs voient le design, la mise en page et les interactions. Les robots d'exploration fonctionnent principalement à partir du code HTML récupéré : texte, liens et signaux structurés.
Ce simulateur d'araignée gratuit récupère une URL et affiche une vue simplifiée et axée sur le texte de ce qu'un robot d'exploration peut accéder plus facilement à partir du code source de la page.
Comment l'utiliser
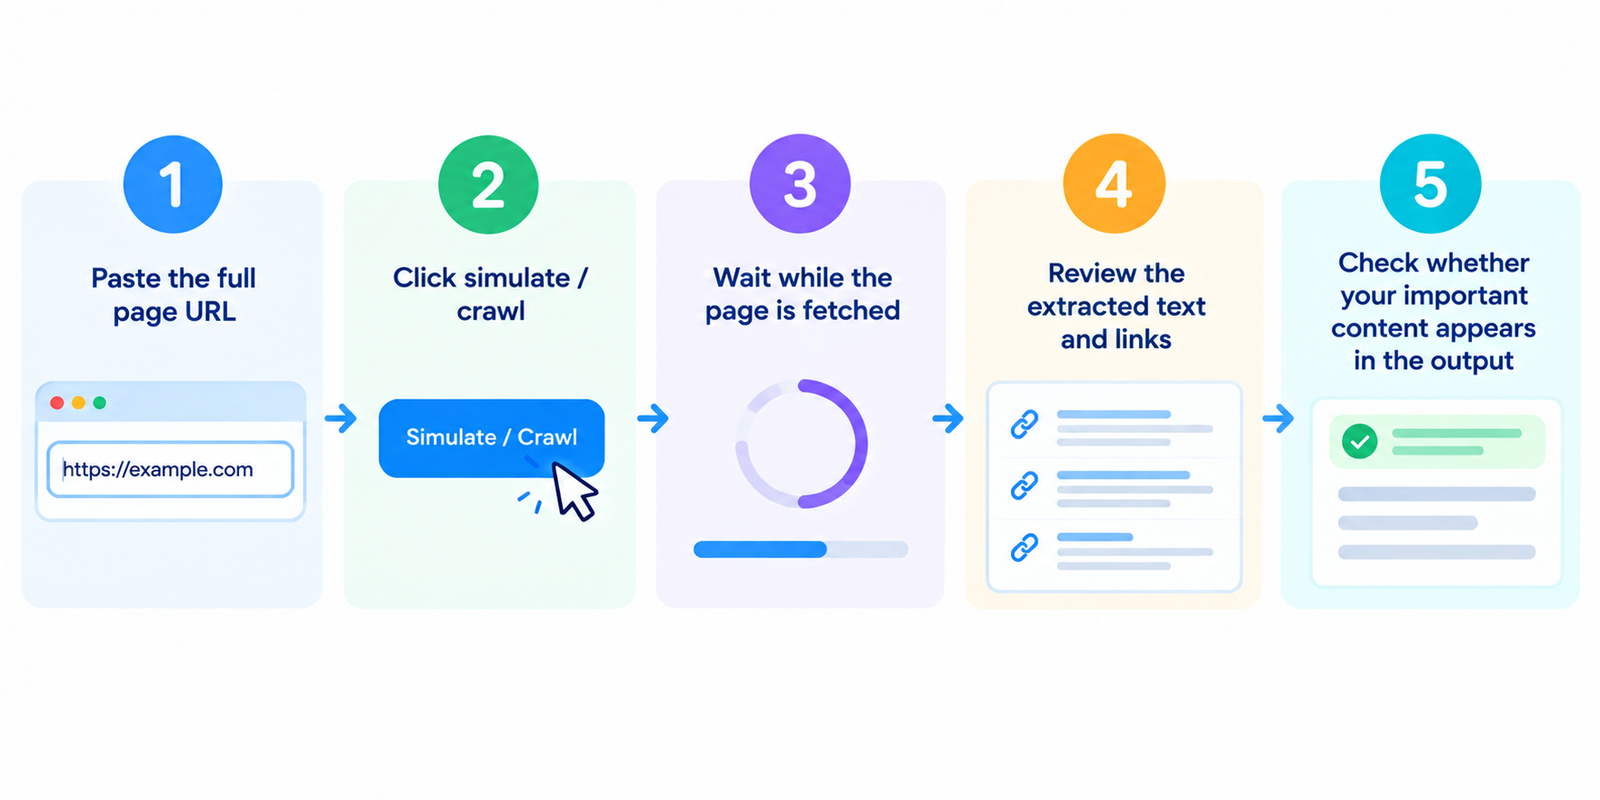
- Collez l'URL complète de la page
- Cliquez sur simuler / explorer
- Patientez pendant le chargement de la page
- Examinez le texte et les liens extraits
- Vérifiez si votre contenu important apparaît dans le résultat
Si le mode par lots est disponible, testez les modèles clés : page d'accueil, pages de catégories, de produits et d'articles.
Ce que cette simulation essaie de montrer
Une récupération de type araignée privilégie généralement :
| Élément | Pourquoi c'est important |
|---|---|
| Texte visible du HTML | Contenu principal disponible sans rendu lourd côté client |
| Liens hypertextes | Chemins que les robots peuvent découvrir ensuite |
| Signaux de titre / méta dans la source | Contexte initial de la page dans le code HTML |
| Texte alternatif (Alt) | Alternatives textuelles pour les images lorsqu'elles sont fournies |
| Statut HTTP | Si l'URL répond correctement |
Il ne repose généralement pas sur une mise en page CSS soignée ou des interactions propres au navigateur.
Vue Araignée vs Vue Navigateur
| Vue du navigateur | Vue de style araignée |
|---|---|
| Page entièrement rendue | Extraction de texte basée sur la source |
| Exécute les scripts côté client | Peut manquer le contenu purement JS |
| Voit le design visuel | Ignore le style |
| Menus / onglets interactifs | Dépend des vrais liens en HTML |
Le Googlebot moderne peut traiter JavaScript mieux que les anciens robots, mais le contenu qui n'apparaît qu'après un rendu client complexe peut toujours être retardé, incomplet ou plus difficile à traiter. Rendre le contenu important disponible dans le code HTML initial reste une excellente pratique.
Ce qu'il faut vérifier dans les résultats
Votre contenu principal est-il présent ?
Les titres, les paragraphes clés, les détails des produits et les FAQ doivent apparaître dans le texte extrait.
Les liens internes importants sont-ils visibles comme de vrais liens ?
La navigation et les liens contextuels doivent exister en tant que véritables cibles href, et non pas seulement comme des gestionnaires de clics.
La page est-elle presque vide en mode araignée ?
Cela peut indiquer un rendu lourd côté client ou un contenu injecté trop tardivement.
Les codes d'état semblent-ils corrects ?
200 est l'idéal pour les pages indexables. Les chaînes de redirection, les erreurs 404 et les réponses 5xx nécessitent une attention particulière.
Y a-t-il trop de texte récurrent (boilerplate) ?
Les menus et les pieds de page sont normaux, mais le contenu principal du corps de texte doit tout de même rester clair.
Problèmes courants que cet outil aide à identifier
- Contenu dépendant de JS — texte critique manquant dans le HTML initial
- Navigation sans lien — menus qui ne sont pas de véritables liens explorables
- Texte extrait insuffisant — la page semble riche visuellement mais contient peu de texte lisible
- Cibles brisées ou redirigées — mauvaises destinations de liens dans la liste extraite
- Texte alternatif manquant — images sans équivalent textuel
- Réponses de statut inattendues — URL bloquées, manquantes ou renvoyant des erreurs
Utilisez le simulateur comme un avertissement précoce, puis vérifiez avec Search Console et des tests en direct.
Conseils d'amélioration pratique
- Assurez-vous que le contenu principal est disponible dans le code HTML rendu côté serveur ou pré-rendu lorsque c'est possible
- Utilisez de vrais liens pour la navigation importante et les chemins internes
- Faites en sorte que les pages indexables renvoient des réponses 200 propres
- Ajoutez un texte alternatif pertinent lorsque les images transmettent des informations
- Évitez de compter sur le « clic pour charger » pour le contenu SEO essentiel
- Testez à nouveau après des refontes, des changements de thème ou des mises à jour de frameworks JS
Pour des contrôles techniques plus approfondis, associez cet outil aux sources, aux statuts et aux outils d'indexation.
FAQ
Cet outil est-il gratuit ?
Oui. Les simulations standard ne nécessitent pas de compte.
Est-ce exactement ainsi que Googlebot voit ma page ?
Pas exactement. C'est une vue simplifiée de type araignée. Les systèmes de Google sont plus avancés et peuvent exécuter du JavaScript, mais cela reste utile pour repérer les lacunes majeures en matière de contenu et de liens.
Pourquoi mon texte est-il absent ici mais visible dans le navigateur ?
Le contenu n'est peut-être chargé qu'après l'exécution du JavaScript côté client.
Cet outil peut-il explorer l'ensemble de mon site web ?
La plupart des versions gratuites analysent une page à la fois. Testez des URL représentatives de chaque modèle.
Une bonne vue araignée garantit-elle des classements ?
Non. Cela aide seulement à confirmer que le contenu et les liens sont détectables. La pertinence, la qualité et la concurrence déterminent toujours les classements.
Outils associés
- Obtenir le code source d'une page Web
- Vérificateur d'index Google
- Recherche de liens brisés
- Générateur de Robots.txt
- Analyseur de balises Meta
Remarque : Les résultats de la simulation dépendent de la réponse HTML récupérée. La protection contre les bots, la personnalisation et les applications rendues côté client peuvent affecter ce qui apparaît.