Search Engine Spider Simulator
Nhập URL
Trình mô phỏng Spider Công cụ Tìm kiếm
Mọi người nhìn thấy thiết kế, bố cục và các tương tác. Các trình thu thập thông tin chủ yếu hoạt động dựa trên mã HTML được tải về: văn bản, liên kết và các tín hiệu có cấu trúc.
Trình mô phỏng spider miễn phí này sẽ tải một URL và hiển thị một chế độ xem đơn giản, tập trung vào văn bản về những gì trình thu thập thông tin có thể truy cập dễ dàng hơn từ mã nguồn của trang.
Cách sử dụng
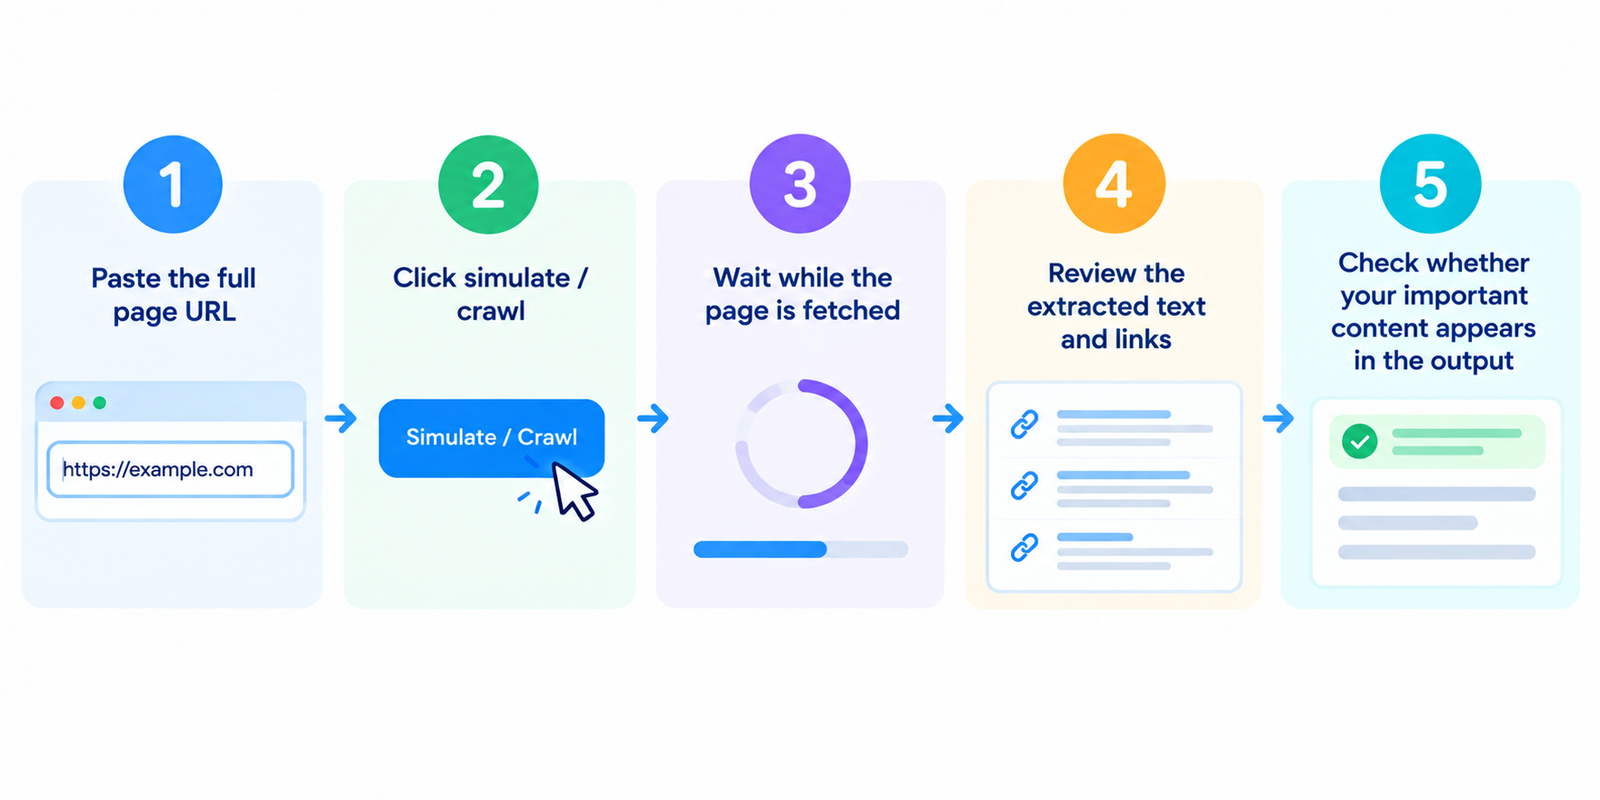
- Dán toàn bộ URL của trang
- Nhấp vào mô phỏng / thu thập thông tin
- Đợi trong khi trang đang được tải về
- Xem lại văn bản và liên kết đã trích xuất
- Kiểm tra xem nội dung quan trọng của bạn có xuất hiện trong kết quả hay không
Nếu có chế độ hàng loạt, hãy kiểm tra các mẫu chính: trang chủ, danh mục, sản phẩm và các trang bài viết.
Mô phỏng này đang cố gắng hiển thị điều gì
Quá trình tải theo phong cách spider thường ưu tiên:
| Phần tử | Tại sao nó quan trọng |
|---|---|
| Văn bản hiển thị từ HTML | Nội dung cốt lõi có sẵn mà không cần kết xuất phía máy khách nặng nề |
| Liên kết neo (Anchor links) | Các đường dẫn mà trình thu thập thông tin có thể khám phá tiếp theo |
| Tín hiệu tiêu đề / thẻ meta trong mã nguồn | Ngữ cảnh trên trang sớm trong mã HTML |
| Văn bản thay thế (Alt text) | Văn bản thay thế cho hình ảnh khi được cung cấp |
| Trạng thái HTTP | Liệu URL có phản hồi suôn sẻ hay không |
Nó thường không dựa vào bố cục CSS bóng bẩy hoặc các tương tác chỉ có trên trình duyệt.
Góc nhìn của Spider so với Góc nhìn của Trình duyệt
| Góc nhìn trình duyệt | Góc nhìn kiểu spider |
|---|---|
| Trang được kết xuất đầy đủ | Trích xuất văn bản dựa trên mã nguồn |
| Chạy các tập lệnh phía máy khách | Có thể bỏ lỡ nội dung chỉ có JS |
| Nhìn thấy thiết kế trực quan | Bỏ qua kiểu dáng (styling) |
| Menu/tab tương tác | Phụ thuộc vào các liên kết thực trong HTML |
Googlebot hiện đại có thể xử lý JavaScript tốt hơn so với các trình thu thập thông tin cũ, nhưng nội dung chỉ xuất hiện sau khi kết xuất phía máy khách phức tạp vẫn có thể bị trì hoãn, không đầy đủ hoặc khó xử lý hơn. Việc làm cho nội dung quan trọng có sẵn trong mã HTML ban đầu vẫn là một thực tiễn tốt nhất.
Những điều cần kiểm tra trong kết quả
Nội dung chính của bạn có hiện diện không?
Tiêu đề, các đoạn văn chính, chi tiết sản phẩm và câu hỏi thường gặp phải xuất hiện trong văn bản đã trích xuất.
Các liên kết nội bộ quan trọng có hiển thị dưới dạng liên kết thực không?
Điều hướng và các liên kết theo ngữ cảnh phải tồn tại dưới dạng mục tiêu href thích hợp, chứ không chỉ là trình xử lý sự kiện nhấp chuột.
Trang có hầu như trống rỗng ở chế độ xem spider không?
Điều đó có thể cho thấy việc kết xuất phía máy khách nặng nề hoặc nội dung được chèn quá muộn.
Các mã trạng thái có vẻ bình thường không?
200 là lý tưởng cho các trang có thể lập chỉ mục. Chuỗi chuyển hướng, lỗi 404 và phản hồi 5xx cần được chú ý.
Có quá nhiều nội dung mẫu lặp lại (boilerplate) không?
Menu và chân trang là bình thường, nhưng nội dung chính độc đáo vẫn phải rõ ràng.
Các vấn đề thường gặp mà công cụ này giúp phát hiện
- Nội dung phụ thuộc vào JS — văn bản quan trọng bị thiếu trong mã HTML ban đầu
- Điều hướng không phải liên kết — các menu không phải là liên kết có thể thu thập thông tin thực sự
- Văn bản trích xuất quá ít — trang trông có vẻ phong phú về mặt hình ảnh nhưng có rất ít đoạn văn bản đọc được
- Mục tiêu bị hỏng hoặc chuyển hướng — đích liên kết kém trong danh sách đã trích xuất
- Thiếu văn bản thay thế (alt text) — hình ảnh không có nội dung văn bản tương đương
- Phản hồi trạng thái bất ngờ — các URL bị chặn, bị thiếu hoặc bị lỗi
Sử dụng trình mô phỏng như một cảnh báo sớm, sau đó xác minh bằng Search Console và kiểm tra trực tiếp.
Mẹo cải thiện thực tế
- Đảm bảo nội dung chính có sẵn trong mã HTML được kết xuất từ máy chủ hoặc kết xuất trước (prerendered) khi có thể
- Sử dụng liên kết thực cho điều hướng quan trọng và đường dẫn nội bộ
- Giữ cho các trang có thể lập chỉ mục trả về phản hồi 200 sạch sẽ
- Thêm văn bản thay thế có ý nghĩa nơi hình ảnh truyền tải thông tin
- Tránh phụ thuộc vào “nhấp để tải” đối với nội dung SEO thiết yếu
- Kiểm tra lại sau khi thiết kế lại, thay đổi giao diện (theme) hoặc cập nhật khung JS (JS framework)
Để kiểm tra kỹ thuật sâu hơn, hãy kết hợp công cụ này với các công cụ nguồn, trạng thái và lập chỉ mục.
Câu hỏi thường gặp
Công cụ này có miễn phí không?
Có. Các mô phỏng tiêu chuẩn không yêu cầu tài khoản.
Đây có chính xác là cách Googlebot nhìn thấy trang của tôi không?
Không hẳn. Đây là góc nhìn theo kiểu spider được đơn giản hóa. Hệ thống của Google tiên tiến hơn và có thể kết xuất JavaScript, nhưng công cụ này vẫn rất hữu ích để phát hiện các khoảng trống lớn về nội dung/liên kết.
Tại sao văn bản của tôi bị thiếu ở đây nhưng lại hiển thị trên trình duyệt?
Nội dung có thể chỉ được tải sau khi JavaScript phía máy khách chạy.
Công cụ này có thể thu thập thông tin toàn bộ trang web của tôi không?
Hầu hết các phiên bản miễn phí phân tích từng trang một. Hãy kiểm tra các URL đại diện từ mỗi mẫu.
Góc nhìn spider tốt có đảm bảo thứ hạng không?
Không. Nó chỉ giúp xác nhận rằng nội dung và liên kết có thể được khám phá. Sự liên quan, chất lượng và tính cạnh tranh mới là yếu tố quyết định thứ hạng.
Các công cụ liên quan
- Lấy mã nguồn của trang web
- Trình kiểm tra chỉ mục Google
- Trình tìm liên kết hỏng
- Trình tạo Robots.txt
- Trình phân tích thẻ Meta
Lưu ý: Kết quả mô phỏng phụ thuộc vào phản hồi HTML được tải về. Bảo vệ chống bot, tính cá nhân hóa và các ứng dụng kết xuất phía máy khách có thể ảnh hưởng đến những gì hiển thị.