Search Engine Spider Simulator
URLを入力
検索エンジン・スパイダーシミュレーター
人間はデザイン、レイアウト、インタラクションを見ますが、クローラーは主に取得したHTML(テキスト、リンク、構造化されたシグナル)から動作します。
この無料のスパイダーシミュレーターは、URLを取得し、クローラーがページソースからアクセスしやすい簡略化されたテキスト中心のビューを表示します。
使い方
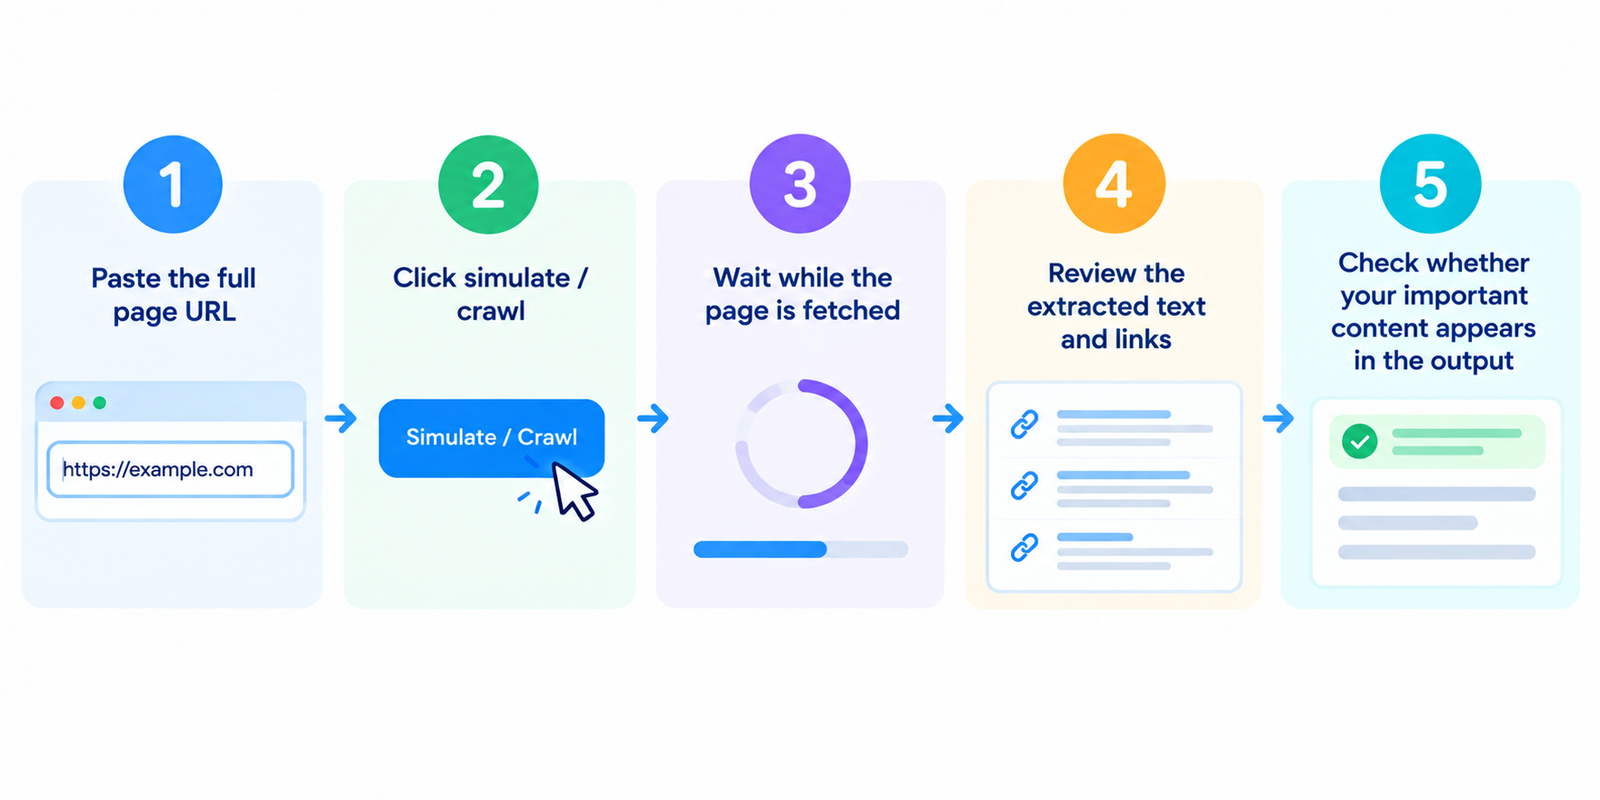
- ページの完全なURLを貼り付けます
- シミュレート/クロールをクリックします
- ページの取得を待ちます
- 抽出されたテキストとリンクを確認します
- 重要なコンテンツが結果に表示されているか確認します
バッチモードが利用可能な場合は、ホームページ、カテゴリ、商品、記事ページなどの主要なテンプレートをテストしてください。
このシミュレーションが示そうとしていること
スパイダー形式の取得では通常、以下が優先されます:
| 要素 | 重要性 |
|---|---|
| HTMLからの可視テキスト | 重いクライアントレンダリングなしで利用可能なコアコンテンツ |
| アンカーリンク | クローラーが次に発見できるパス |
| ソース内のタイトル/メタシグナル | HTML内の初期のオンページコンテキスト |
| altテキスト | 画像が提供されている場合のテキストの代替 |
| HTTPステータス | URLが正常に応答しているか |
通常、洗練されたCSSレイアウトやブラウザ固有のインタラクションには依存しません。
スパイダービューとブラウザビューの比較
| ブラウザビュー | スパイダー風ビュー |
|---|---|
| 完全にレンダリングされたページ | ソースベースのテキスト抽出 |
| クライアントサイドスクリプトを実行 | JS固有のコンテンツを見逃す可能性がある |
| 視覚的なデザインを確認 | スタイリングを無視 |
| インタラクティブなメニュー/タブ | HTML内の実際のリンクに依存する |
現代のGooglebotは以前のクローラーよりもJavaScriptを処理できるようになりましたが、複雑なクライアントレンダリングの後にのみ表示されるコンテンツは、依然として遅延したり、不完全だったり、処理が難しくなったりする可能性があります。初期のHTMLで重要なコンテンツを利用できるようにすることは、引き続き強力なベストプラクティスです。
結果で確認すべきこと
メインコンテンツは存在しますか?
見出し、主要な段落、商品の詳細、FAQが抽出されたテキストに表示されている必要があります。
重要な内部リンクが実際のリンクとして表示されていますか?
ナビゲーションや文脈に沿ったリンクは、クリックハンドラーだけでなく、適切な href ターゲットとして存在している必要があります。
スパイダービューでページがほとんど空になっていますか?
それは、重いクライアントサイドレンダリングや、注入が遅すぎるコンテンツを示している可能性があります。
ステータスコードは正常ですか?
インデックス可能なページには200が理想的です。リダイレクトチェーン、404、5xx応答には注意が必要です。
ボイラープレート(定型文)が多すぎませんか?
メニューやフッターは正常ですが、独自の本文コンテンツも明確である必要があります。
このツールで表面化しやすくなる一般的な問題
- JS依存のコンテンツ — 初期HTMLから重要なテキストが欠落している
- 非リンクナビゲーション — クロール可能な真のリンクではないメニュー
- 薄い抽出テキスト — 視覚的にはリッチに見えるが、読めるコピーがほとんどないページ
- 壊れた、またはリダイレクトされたターゲット — 抽出されたリスト内の不十分なリンク先
- altテキストの欠落 — テキストによる代替がない画像
- 予期しないステータス応答 — ブロックされた、見つからない、またはエラーが発生しているURL
シミュレーターを早期警戒として使用し、その後Search Consoleとライブテストで検証してください。
実用的な改善のヒント
- 可能な場合は、サーバー側でレンダリングされたHTMLまたは事前レンダリングされたHTMLでプライマリコンテンツを利用できるようにする
- 重要なナビゲーションや内部パスには実際のリンクを使用する
- インデックス可能なページからクリーンな200応答を返すようにする
- 画像が情報を伝えている場合は、意味のあるaltテキストを追加する
- 必須のSEOコンテンツを「クリックして読み込む」ことに依存しないようにする
- リデザイン、テーマの変更、JSフレームワークのアップデート後に再テストする
より深い技術的チェックのために、ソース、ステータス、インデックスツールとこれを組み合わせて使用してください。
よくある質問(FAQ)
このツールは無料ですか?
はい。標準的なシミュレーションにアカウントは必要ありません。
これがGooglebotのページの見え方とまったく同じですか?
まったく同じではありません。簡略化されたスパイダー風のビューです。Googleのシステムはより高度でJavaScriptをレンダリングする場合がありますが、主要なコンテンツやリンクのギャップを見つけるのに役立ちます。
ここでテキストが欠落しているのに、ブラウザでは表示されるのはなぜですか?
クライアントサイドのJavaScriptが実行された後にのみコンテンツが読み込まれている可能性があります。
これでウェブサイト全体をクロールできますか?
ほとんどの無料バージョンは一度に1ページを分析します。各テンプレートから代表的なURLをテストしてください。
優れたスパイダービューはランキングを保証しますか?
いいえ。コンテンツとリンクが発見可能であることを確認するのに役立つだけです。関連性、品質、競合が引き続きランキングを決定します。
関連ツール
- Get Source Code of Webpage
- Google Index Checker
- Broken Links Finder
- Robots.txt Generator
- Meta Tags Analyzer
注意: シミュレーションの結果は、取得されたHTML応答によって異なります。ボットの保護、パーソナライゼーション、クライアントでレンダリングされるアプリが表示内容に影響を与える可能性があります。