Search Engine Spider Simulator
輸入一個 URL
搜尋引擎蜘蛛模擬器
人類看到的是設計、版面配置和互動。而網路爬蟲(Crawlers)主要根據抓取到的 HTML 來運作:文字、連結和結構化訊號。
這個免費的蜘蛛模擬器會抓取網址,並顯示一個簡化、以文字為中心的檢視畫面,讓您了解爬蟲從網頁原始碼中更容易存取到的內容。
如何使用
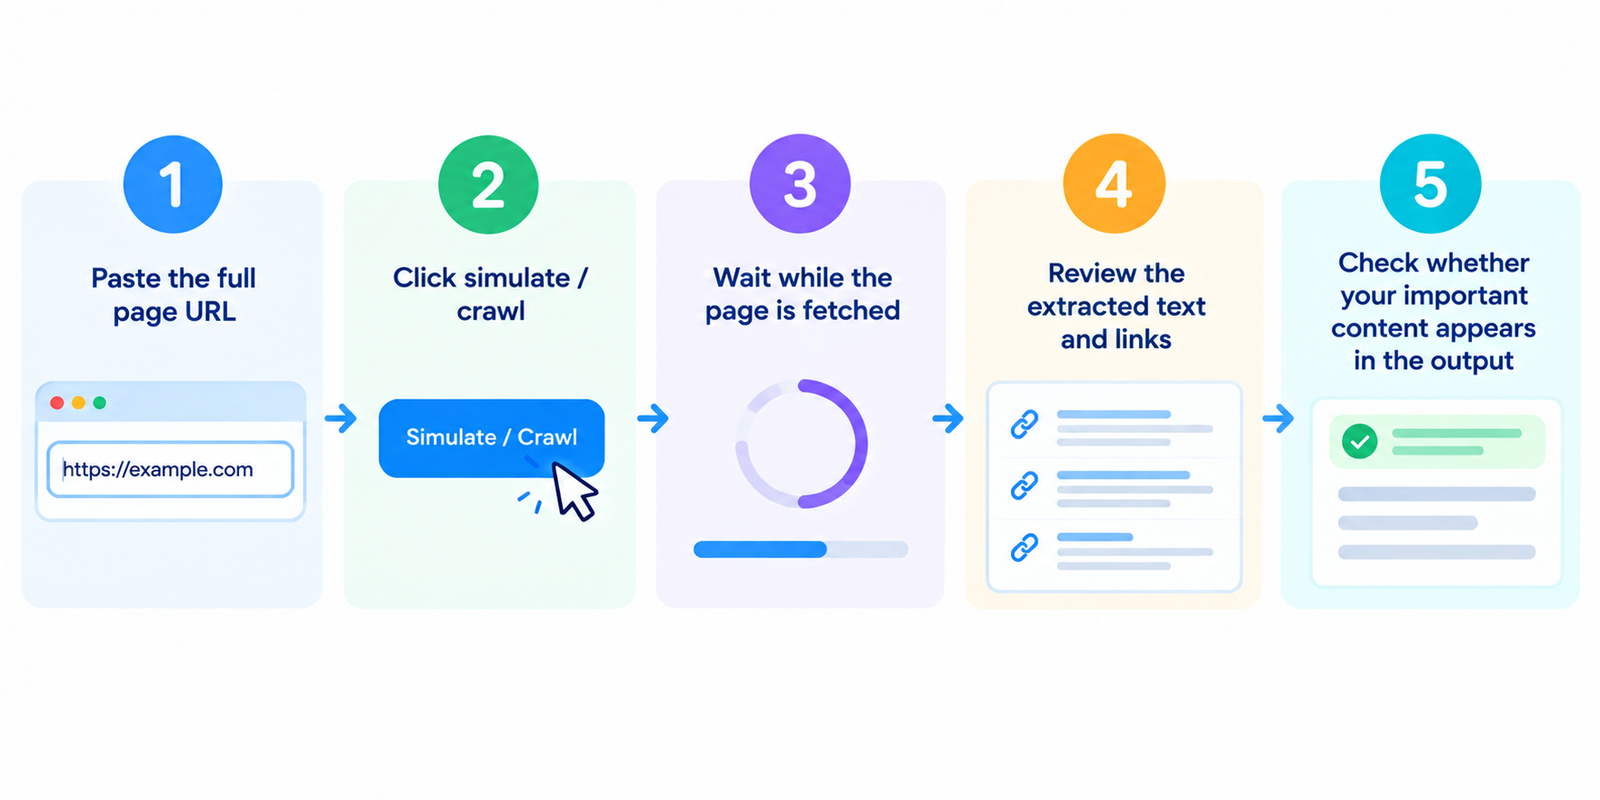
- 貼上完整的網頁網址
- 點擊模擬 / 抓取
- 等待網頁載入完成
- 檢視萃取出的文字和連結
- 檢查您的重要內容是否出現在輸出結果中
若批次模式可用,請測試主要的範本:首頁、分類頁、產品頁和文章頁。
此模擬旨在展示什麼
蜘蛛類型的抓取通常會優先處理:
| 元素 | 為什麼它很重要 |
|---|---|
| HTML 中的可見文字 | 不需要繁重用戶端算繪即可取得的核心內容 |
| 錨點連結 | 爬蟲接下來可以發現的路徑 |
| 原始碼中的標題 / 中繼(meta)訊號 | HTML 中的早期頁面內上下文 |
| 替代文字(Alt text) | 提供圖片時的文字替代方案 |
| HTTP 狀態 | 網址是否有正常回應 |
它通常不依賴精美的 CSS 版面配置或僅限瀏覽器的互動。
蜘蛛檢視與瀏覽器檢視
| 瀏覽器檢視 | 蜘蛛樣式檢視 |
|---|---|
| 完整算繪的頁面 | 基於原始碼的文字萃取 |
| 執行用戶端指令碼 | 可能會遺漏僅限 JS 的內容 |
| 看見視覺設計 | 忽略樣式 |
| 互動式選單/分頁 | 取決於 HTML 中的真實連結 |
現代的 Googlebot 處理 JavaScript 的能力比舊版爬蟲更強,但是僅在複雜的用戶端算繪之後才出現的內容,仍然可能會延遲、不完整或更難處理。將重要內容放在初始 HTML 中可用,依然是極佳的做法。
在結果中應該檢查什麼
您的主要內容是否存在?
標題、關鍵段落、產品詳細資料和常見問題(FAQ)都應該出現在萃取的文字中。
重要的內部連結是否顯示為真實連結?
導覽列和上下文連結應該存在為適當的 href 目標,而不僅僅是點擊處理常式(click handlers)。
在蜘蛛檢視中,頁面是否幾乎是空的?
這可能表示有繁重的用戶端算繪,或是內容注入得太晚。
狀態碼看起來正常嗎?
200 是可編入索引頁面的理想狀態。重新導向鏈、404 和 5xx 回應需要特別注意。
是否有過多的樣版套用文字(boilerplate)?
選單和頁尾是正常的,但獨特的內文內容仍應保持清晰。
這有助於浮現的常見問題
- 依賴 JS 的內容 — 初始 HTML 中遺漏了關鍵文字
- 非連結導覽 — 不是真正可爬取連結的選單
- 萃取的文字稀少 — 頁面視覺上看起來很豐富,但可讀性複製文字很少
- 損壞或重新導向的目標 — 萃取清單中的不良連結目的地
- 遺漏替代文字 — 沒有文字對應項目的圖片
- 未預期的狀態回應 — 被封鎖、遺漏或發生錯誤的網址
將模擬器作為早期預警,然後透過 Search Console 和即時測試進行驗證。
實用的改善建議
- 確保主要內容盡可能在伺服器端算繪(server-rendered)或預先算繪(prerendered)的 HTML 中可用
- 將真實連結用於重要的導覽和內部路徑
- 保持可編入索引的頁面傳回乾淨的 200 回應
- 在圖片傳達資訊的位置新增有意義的替代文字(alt text)
- 避免對重要的 SEO 內容依賴「點擊載入」(“click to load”)
- 在重新設計、佈景主題變更或 JS 架構更新後重新測試
若要進行更深入的技術檢查,請將此工具與原始碼、狀態和索引工具搭配使用。
常見問題
這個工具是免費的嗎?
是的。標準模擬不需要帳戶。
這完全是 Googlebot 看我網頁的方式嗎?k
不完全是。這是一個簡化的蜘蛛樣式檢視。Google 的系統更為先進,可能會算繪 JavaScript,但這對於尋找主要的內容/連結缺口仍然很有用。
為什麼我的文字在這裡遺漏了,但在瀏覽器中卻看得到?k
該內容可能是在用戶端 JavaScript 執行後才載入的。
這可以爬取我的整個網站嗎?
大多數免費版本一次分析一個頁面。請測試來自每個範本的代表性網址。
良好的蜘蛛檢視能保證排名嗎?
不行。它只能協助確認內容和連結是可以被發現的。關聯性、品質和競爭度仍然決定了排名。
相關工具
注意:模擬結果取決於抓取到的 HTML 回應。機器人防護、個人化和用戶端算繪應用程式可能會影響顯示的內容。